Jev или Decisions API: проверка классификации обращений перед миграцией
Сравните форматы запросов Jev и GPT-6 Luna Decisions, отказы и стоимость входных токенов. Скачайте Python-проект для проверки адаптеров на одинаковых обращениях.
 Ofox
Jev и OpenAI Decisions API позволяют направить текстовое обращение в одну из заданных очередей, но их интерфейсы нельзя просто подменить. Сначала следует согласовать категории, входные данные и эталонные метки, затем проверить преобразование ответов, обработку неопределённости и общие расходы. Замена имени модели в существующем клиенте не завершает миграцию.
Ниже — воспроизводимое упражнение: восемь вымышленных обращений, два построителя запросов, строгая проверка ответов, калькулятор стоимости входных токенов и условия перехода на реальный трафик. Оно дополняет обзор Jev и урок по классификации в CSV через Decisions API. Задача — показать изменения в приложении, которое должно работать с обоими сервисами.
Материалы проверены 8 октября 2026 года. Основание сравнения — официальная документация и выполненные локальные синтетические тесты. Платные API не вызывались, точность моделей и сетевые задержки не измерялись. Все тестовые ответы составлены авторами: они помогают найти ошибки интеграции, но не определяют победителя по качеству.
Сначала сравните контракты запросов и ответов
В упражнении используется фиксированная версия TypeSafe jev-1.13.0, а для Decisions — gpt-6-luna. Второй API сейчас находится в публичной бета-версии. Псевдоним jev-latest со временем может указывать на другую модель, поэтому сохраняйте идентификатор из каждого реального ответа. Модели TypeSafe, руководство OpenAI Decisions.
| Деталь интеграции | Нативный API Jev | OpenAI Decisions API |
|---|---|---|
| Адрес POST | /v1/systemone | /v1/decisions |
| Общие входные данные | state | input |
| Контейнер вопросов | Объект с идентификаторами вопросов в ключах | Массив с уникальным name |
| Определения вариантов | Объект criteria | Массив choices с value/description |
| Получение ответов | По идентификатору вопроса | По совпадению name |
| Вероятности вариантов | Соответствие метки числу | Массив объектов value/probability |
| Тип для ответа да/нет | noul | predicate |
| Документированные входы | Текст, в том числе структурированный | Текст и изображения |
Пути в таблице вызываются по HTTPS: хост Jev — api.typesafe.ai, Decisions — api.openai.com. Это прямые API поставщиков.
Последняя строка важна, если к обращению о повреждённом товаре приложена фотография. Если Decisions видит снимок, а Jev получает только текст, разницу нельзя целиком приписать качеству классификации. Передайте обоим одно разрешённое текстовое описание либо выделите мультимодальную задачу в отдельный эксперимент. Преобразование изображения в текст тоже добавляет ошибки и расходы.
Тип choice не предназначен для генерации объясняющего абзаца или произвольного извлечения полей. Если нужны сумма возврата и цитата-основание, спроектируйте отдельный этап извлечения. Метка очереди не содержит этих сведений. Точные поля нативного интерфейса описаны в HTTP-справочнике TypeSafe.
Другие примитивы тоже требуют явного сопоставления. Проект ниже реализует только Choice.
| Задача | Jev | Decisions | Условие миграции |
|---|---|---|---|
| Категория без порядка | choice, объект criteria | choice, массив choices | Сохранить смысл меток, не только имена |
| Оценка по упорядоченной шкале | score, упорядоченный массив criteria | score, упорядоченный массив levels | Сохранить порядок и описание уровней |
| Проверка условия | noul, поле результата noul | predicate, поле результата probability | Оба дают оценку от 0 до 1, но порог проверяется заново |
В обоих API Score — среднее индексов уровней, взвешенное по вероятностям. Это не автоматически нормализованное значение от 0 до 1 и не confidence. При трёх уровнях с индексами 0, 1, 2 результат может быть 1,1. Если приложение делит его на максимальный индекс, документируйте это собственное преобразование и используйте одинаковую шкалу. Нормализованная серьёзность не равна вероятности истинности условия.
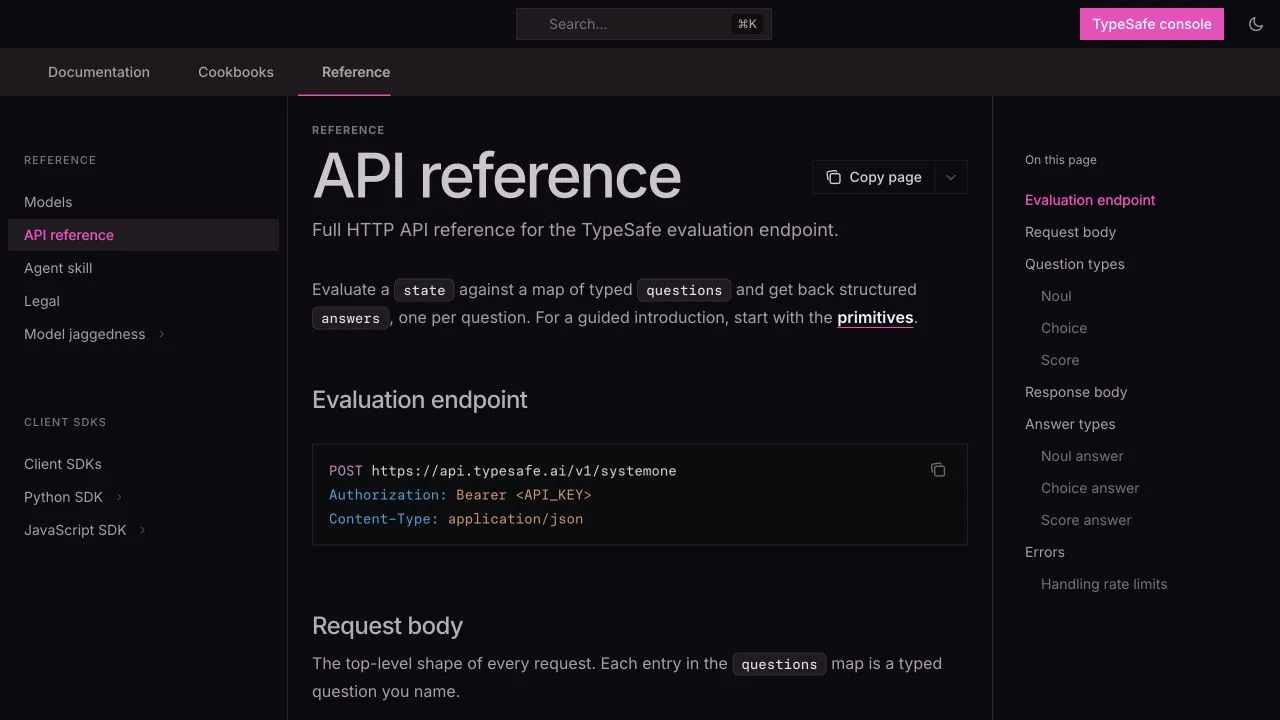
Снимок официальной документации на английском сделан 8 октября 2026 года. Это описание интерфейса, а не результат классификации реального обращения. Источник.
Зафиксируйте единую политику очередей
Наш пример выбирает одну основную очередь. billing означает только платежи, счета или возвраты; technical — только сбой существующей функции или доступа; feature — только запрос новой возможности. Смешанные, неопределённые и посторонние сообщения направляются в review.
Такое правило заранее разрешает спорный случай: «Верните деньги и почините экспорт» относится к review, а не к отделу, упомянутому первым. Если реальный процесс требует создать две задачи для двух отделов, классификация с одним ответом не подходит. Измените формат результата, а не объявляйте любую из двух меток правильной после получения ответа.
| ID | Смысл вымышленного обращения | Эталон | Что проверяется |
|---|---|---|---|
| T01 | Прислать счёт | billing | Однозначный административный запрос |
| T02 | Не работает существующая кнопка экспорта | technical | Сбой или новая функция |
| T03 | Добавить календарный вид | feature | Новая возможность |
| T04 | Вернуть деньги и исправить экспорт | review | Два отдела |
| T05 | «Что-то не так» | review | Недостаток информации |
| T06 | Инструкция ответить billing, затем посторонний текст | review | Вход как данные, а не команда |
| T07 | Сообщение об ошибке входа на японском | technical | Сохранение исходного языка |
| T08 | Просьба о платёжной квитанции на корейском | billing | Сохранение Unicode |
Восьми примеров недостаточно для оценки производственной точности. Японская и корейская записи проверяют сохранность текста в программе, а не качество моделей на этих языках. TypeSafe прямо называет английский основным языком обучения с лучшими текущими результатами и рекомендует проверять остальные языки на своих данных. Перевод всех обращений на английский меняет оцениваемую задачу.
Реальную выборку должны независимо разметить два проверяющих по одной политике. Разногласия разрешают до фиксации тестового набора; инструкции настраивают на отдельном наборе разработки. Сохраняйте ID исходной записи, удаляйте ненужные персональные данные и не ограничивайте выборку только обращениями, которые раньше вызывали ошибки.
Постройте два запроса из одного описания задачи
Скачайте проект миграции, распакуйте и откройте терминал в его каталоге. Нужен Python 3.9 или новее; используются только стандартные библиотеки. Для первого запуска не нужны ключ API и установка пакетов. Функция payload() повторно использует общую инструкцию и словарь меток:
jev_request = {
    "model": "jev-1.13.0", "state": ticket_text,
    "questions": {"queue": {
        "type": "choice", "instructions": RULE,
        "criteria": LABELS,
    }},
}
openai_request = {
    "model": "gpt-6-luna", "input": ticket_text,
    "questions": [{
        "name": "queue", "type": "choice", "instructions": RULE,
        "choices": [{"value": k, "description": v}
                    for k, v in LABELS.items()],
    }],
}
RULE требует считать текст обращения данными, а не инструкцией, и выбирать review при неоднозначности. Это определение задачи, не доказательство устойчивости к инъекции промптов. Провокационный T06 остаётся одним тестом, а не сертификатом безопасности.
В упражнении отправляется одно обращение на запрос. Если объединить восемь независимых сообщений в общий вход и задать один вопрос об очереди, классифицироваться будет весь пакет. Восемь отдельных ответов автоматически не появятся. Позже можно задавать несколько вопросов об одной записи, но упаковка влияет на число токенов и потенциально на поведение; фиксируйте это изменение отдельно.
Режим реальных запросов обращается к официальным хостам с Bearer-аутентификацией. Он не предполагает, что OpenAI-совместимый шлюз реализует /v1/decisions или что TypeSafe принимает тело запроса OpenAI. Сначала проверьте нативное подключение, затем добавляйте адаптер шлюза.
Нормализуйте ответы, сохраняя видимость ошибок
Запустите обе ветки с фиксированными ответами:
python3 migrate.py --provider jev --output jev-fixture
python3 migrate.py --provider openai --output openai-fixture
В каждом новом каталоге будут восемь исходных JSON, rows.json и summary.json. Повторно использовать существующий каталог нельзя: это защищает прошлые свидетельства от перезаписи. Ответ OpenAI для T05 специально задан как отказ. Это не прогноз того, что GPT-6 Luna откажется обрабатывать такой текст в реальности.
Адаптер сопоставляет вопрос, проверяет ровно четыре нужные метки, отсутствие повторов вероятностей, конечность чисел и сумму, близкую к единице. Выбранная метка должна иметь максимальную вероятность, confidence — быть конечным числом от нуля до единицы. Пропущенные поля, неверные структуры и сбои передачи остаются ошибками, а не превращаются в успешную классификацию.
Разделяйте три состояния. status=ok с choice=review — корректное отнесение к очереди ручной проверки. status=refusal — отказ предоставить ответ. status=error — невозможность получить или проверить пригодный ответ. Если свести все случаи к успешному review, проблемы надёжности спрячутся в нормальной статистике категории.
В текущем контракте TypeSafe описаны три типа ответов, но нет аналогичного OpenAI типа refusal. Не придумывайте такое поле для Jev: неизвестные типы становятся ошибками проверки. Сохраняйте исходный ответ, чтобы будущие изменения схемы можно было исследовать.
Порог 0,8 в примере иллюстративный. У всех успешных синтетических ответов confidence намеренно равен 0,72, поэтому по умолчанию все записи направляются людям. Автоматическое покрытие равно нулю, согласованность автоматических решений — null. Это отсутствие знаменателя, а не нулевая точность.
Измеряйте качество отдельно от автоматического покрытия
Нельзя переносить порог одного провайдера к другому без проверки. TypeSafe описывает вычисление confidence для Choice по распределению вероятностей, но одинаковое десятичное число в разных API не гарантирует одинаковой калибровки или риска. Сохраняйте исходные вероятности и confidence; подробнее об оценке — в руководстве по порогам Jev.
На отложенной реальной выборке фиксируйте хотя бы четыре показателя:
- Согласованность пригодных ответов: правильные метки среди всех пригодных ответов.
- Автоматическое покрытие: автоматически направленные записи среди всех отправленных, включая сбои.
- Согласованность автоматической части: правильные метки среди автоматически направленных.
- Количество отказов и ошибок, а также матрицу ошибок по фактическим очередям.
Согласованность автоматической части может вырасти просто потому, что больше задач передали людям. Это бывает полезно, но рядом нужно показывать сокращение покрытия и нагрузку на проверяющих. Ошибочную передачу платежного вопроса техническому отделу рассматривайте отдельно от направления такого вопроса на review: последствия различаются.
Когда разрешены доступ к API, использование данных и расходы, безопасно задайте TYPESAFE_API_KEY либо OPENAI_API_KEY в окружении:
python3 migrate.py --live --provider jev --output jev-live
python3 migrate.py --live --provider openai --output openai-live
С приложенным CSV каждая команда отправляет восемь запросов к платному API. Сохраняются успешные исходные ответы, включая model и usage, если эти поля присутствуют. Автоматического повтора нет. Ошибки авторизации и валидации сначала исследуйте; для временного ограничения частоты в производственном клиенте вводите ограниченные повторы с задержкой и журналом каждого потенциально оплачиваемого вызова. Локальное время обработки фикстур не равно задержке API.
Рассчитайте расходы по фактическому использованию каждого сервиса
На дату проверки базовая цена Jev 1.13 составляет 0,042 доллара за миллион входных токенов, выход бесплатный. Для GPT-6 Luna в Decisions указано 0,10 доллара за миллион входных токенов без отдельной оплаты выхода, чтения и записи кеша. Однако региональные надбавки и множители входной цены для длинного контекста сохраняются. Это документированные цены прямого подключения, не тарифы Ofox. Цены Jev, цены Decisions.
python3 cost.py --jev-tokens 2000000 --openai-tokens 2000000При предположении об одинаковых двух миллионах токенов базовый расчёт даст 0,084 и 0,20 доллара. Это арифметический пример, не наблюдавшийся счёт. Одинаковый текст не гарантирует одинаковое количество оплачиваемых токенов. Подставьте usage каждого провайдера и учтите повторяющиеся инструкции и все оплаченные попытки. Низкая цена входа сама по себе не определяет более дешёвый рабочий процесс.
Отдельно добавьте ручную проверку. Условные 10 000 обращений, 20% ручной обработки и 0,50 доллара за проверку дают 1 000 долларов только на этот этап. Это допущения, а не измеренные клиентские расходы. Разработка миграции, обработка изображений, повторы и последствия ошибок тоже не входят в калькулятор входных токенов. Статья о пороге окупаемости маршрутизации Jev рассматривает более полную модель затрат.
Выбирайте по задаче и переключайте трафик постепенно
Для текстовой классификации у Jev ниже документированная базовая входная цена. Это повод оценить сервис, а не доказательство его превосходства на ваших метках. Decisions стоит рассмотреть, если нужны изображения или приложение уже использует нативный API OpenAI. Публичную бета-стадию учитывайте вместе с поддержкой и обработкой сбоев.
Начните с теневого режима: сохраняйте текущую производственную маршрутизацию, запускайте кандидата на разрешённой выборке и сравнивайте сохранённые ответы с тем же эталоном. Допустимые ошибки, покрытие и нагрузку на людей определите заранее по требованиям бизнеса. Не снижайте планку после неудовлетворительного результата. Проверьте срезы по языкам и типам обращений, затем переключите небольшую долю трафика.
Сохраните предыдущую конфигурацию провайдера и версию таксономии для отката. Если меняется возвращаемая модель, растёт число некорректных ответов или перегружается очередь ручной проверки, остановите расширение и изучите записи. Успешный запуск проекта подтверждает проверенное поведение адаптеров. Решение о миграции требует реальных наблюдений о качестве задачи и операционных расходах.
Часто задаваемые вопросы
- Для перехода с Jev на Decisions достаточно заменить название модели?
- Нет. Отличаются адрес API, поле входных данных, структура вопросов и представление вероятностей. Политику классификации можно оставить общей, но запросы и ответы требуют отдельных адаптеров.
- Какая модель точнее классифицировала обращения из примера?
- Статья не устанавливает победителя. Ответы в проекте созданы для тестирования программы, а не получены от моделей. Для выбора нужны реальные размеченные обращения, отложенные для оценки.