LLM API 缓存命中率很高,账单为什么没降多少?
区分普通输入、缓存读写与输出费用,用可复算示例核对 LLM API 账单,避免重复计算 token 或把局部节省当成整单降幅。
 Ofox
缓存命中率不能直接换成账单降幅。 先拆开普通输入、缓存读取、缓存写入和输出,再按对应模型与路由单价计算。命中率高,但输出多、写入频繁或失败重试多,整项任务的费用仍可能很高。
本文于 2026 年 9 月 17 日核对官方缓存说明,提供可复算方法;下面的价格示例是假设值,不是 Ofox 现价或客户实测账单。
先确认模型采用哪种缓存规则
当前 OpenAI 缓存文档对 GPT-5.6 及之后模型规定:缓存写入按普通输入单价的 1.25 倍,读取按 0.1 倍。写入费替代该部分 token 的普通输入费,不是在普通输入费之外再加 1.25 倍。
较早模型的规则不同,不能把某代模型“无额外写入费”的说明推广到全部模型。Anthropic 缓存文档也区分读写与保留时长,应查实际模型和对应规则,不能直接套 OpenAI 的倍数。
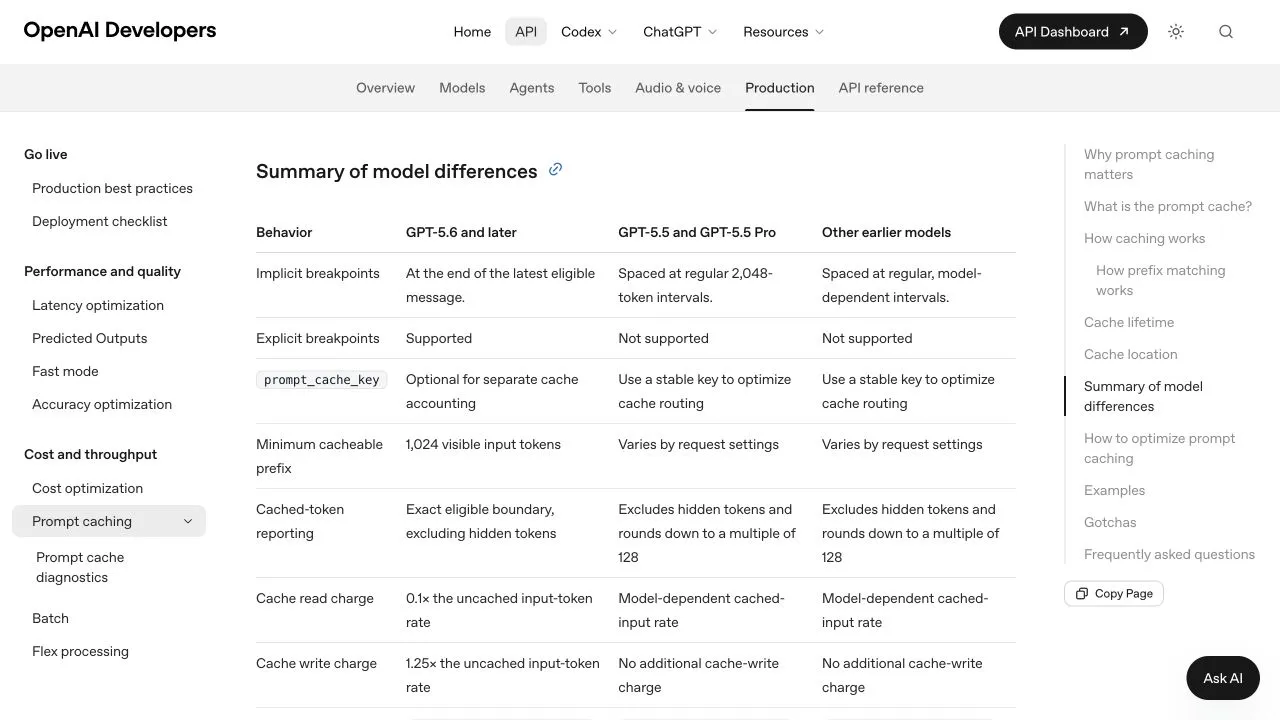
官方截图拍摄于 2026 年 9 月 16 日,保留英文界面。它说明 OpenAI API 的规则,不是 Ofox 路由报价,也不是 Codex 订阅额度表。
把 token 拆成互不重叠的类别
在当前 OpenAI Responses 文档示例中,普通输入的计算为:
普通输入 = input_tokens
         - input_tokens_details.cached_tokens
         - input_tokens_details.cache_write_tokens
不要把这个结构直接套到所有兼容接口。先读其 usage 字段定义;缺失字段表示未知,不能未经核实当作零。计数不能为负,异常时先查字段含义。
将各项统一为每百万 token 单价后:
费用 =(普通输入 × 普通输入价
      + 缓存读取 × 读取价
      + 缓存写入 × 写入价
      + 输出 × 输出价)/ 1,000,000
      + 其他适用费用
币种必须一致。图像 token、每张图片、每秒视频和工具调用费不能直接塞进同一个文本 token 乘法中。
一个只计算前缀的假设例子
假设前缀长 10,000 token,普通输入 $2/百万、写入 $2.50/百万、读取 $0.20/百万。第一次完整写入,之后九次完整命中同一前缀:
| 项目 | 计算 | 费用 |
|---|---|---|
| 首次写入 | 10,000 × $2.50 / 1,000,000 | $0.025 |
| 九次读取 | 9 × 10,000 × $0.20 / 1,000,000 | $0.018 |
| 合计 | 写入加读取 | $0.043 |
| 不复用的对照 | 10 × 10,000 × $2 / 1,000,000 | $0.200 |
前缀费用下降 (0.200 - 0.043) / 0.200 = 78.5%。这个比例不包括输出、新增后缀、工具调用或额外重试,不是整张账单降幅。若发生更多写入或命中不完整,应重新计算。
看加权命中率,更要看完成成本
对同一统计范围,用缓存读取 token 总数除以输入 token 总数;不要把每个请求的百分比简单平均,否则短请求与长请求会被赋予相同权重。仍需核对该接口的输入总数定义。
逐次保留日期、模型、路由、各类用量、重试、扣费与验收结果。比较同一任务所有尝试的总费用,而不是只挑命中率最高的一次。Astra 与 Sol 对比展示为什么供应商与路由也要分开。
核对 Ofox 报价时,需要同时定位 GitHub catalog 实现和当前响应,区分 pricing 与 provider_price.pricing;仓库接口读取动态数据,不是永久静态价表。服务商核查清单给出记录方法。
API 缓存费用不能反推订阅周额度。账户用量问题请看 Codex 恢复时间,图像计费请看图像价格说明。
常见问题
- 缓存命中就一定省钱吗?
- 要看复用次数、读写价格和总账单。缓存读取便宜,不代表首次写入免费;输出和工具等费用也可能占主要部分。
- 可以把所有 input_tokens 都乘普通输入价吗?
- 不能直接这样算。先确认接口是否把缓存 token 包含在输入总量中,拆成互不重叠的类别,再分别计价。
- 示例中的 78.5% 是整张账单的节省吗?
- 不是。它只比较指定前缀的处理费用,排除了输出、新增后缀和工具费;也不是 Ofox 报价或客户账单。