GPT-6.1 Sol 值得升级吗?价格变化、API 迁移与验收方法
GPT-6.1 Sol 已发布。对比 GPT-6 Sol 的价格、推理档位和工具调用限制,附费用计算、Responses API 示例及升级验收方法,帮助你判断是否切换。
 Ofox
如果你已经用 GPT-6 Sol 写代码或处理多步骤任务,GPT-6.1 Sol 值得安排一次对照测试,但有些应用不能只改模型名。 迁移时最需要注意的是:新模型不支持 none 推理档位,工具调用必须使用 Responses API。普通输入和输出的 token 单价与 GPT-6 Sol 相同,官方缓存读取单价则降低了。
OpenAI 的 GPT-6.1 Sol 系统卡补充说明标注的发布日期为 2026 年 9 月 29 日。本文面向准备升级的开发者和团队,分别说明官方已经确认的能力,以及你可以执行的评估方法。本文没有进行付费的 GPT-6.1 Sol 性能测试,也没有验证通过 Ofox 成功完成一次新模型推理请求。
可以直接查看使用入口、兼容性变化、费用计算、迁移步骤或升级判断方法。
GPT-6.1 Sol 在哪里能用?
官方 API 模型 ID 是 gpt-6.1-sol。如果通过产品界面使用,应先检查 ChatGPT Work 或 Codex,不要把普通 Chat 对话的模型菜单当成同一个入口。OpenAI 说明,新模型正在向符合条件的付费套餐开放,实际可见性还受工作区设置和开放进度影响。Enterprise 和 Edu 工作区可能需要管理员启用。发布资料列出了 Sol 的 Standard 和 Fast 模式,Sol Ultrafast 则仍属于后续开放项。这些是产品层面的可用性说明,不代表每个账号都已经获得权限。参见 OpenAI 发布说明资源和 Work、Codex 可用性说明。
开发者需要分开确认三件事:厂商是否发布、所用服务商是否接入、自己的凭据能否调用。菜单里出现一个模型,只回答了其中一部分。如果保存的测试请求仍然调用旧模型,也可能出现“看起来成功,实际上没有测到新模型”的情况。保留 API 返回的模型名称和服务商信息,才能确认测试对象。
本次检查时,Ofox 的状态是什么?
2026 年 9 月 30 日,我们只读查询了 Ofox 公开模型目录:返回 154 条记录,总数也为 154。目录里有 GPT-6 Sol,没有找到 GPT-6.1 Sol。这个结果只证明该时刻公开目录展示的情况,不能推断所有私有路由或后续部署都不支持。
不要直接猜一个 openai/gpt-6.1-sol 填入 Ofox 配置,并把本文当作已经可用的证明。 接入前先在 Ofox 模型目录页面确认精确 ID、支持的接口和当前供应商条款。下文可执行请求示例直连 OpenAI,需要 OpenAI API Key;ChatGPT 订阅和 Ofox Key 都不能直接替代这个凭据。
从 GPT-6 Sol 升级有哪些变化?
OpenAI 将新 Sol 定位为在复杂编程、电脑操作和专业工作上接近 Astra 的模型。这值得拿自己的任务验证,但不能据此说它在所有问题上都超过 Astra。模型具备某种能力,也不等于你的应用自动获得浏览器会话、文件、连接器和执行权限,这些仍由实际运行环境提供。
| 接入时要比较的项目 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 推理档位 | 包含 none | low、medium(默认)、high、xhigh、max;不支持 none 和 minimal |
| Chat Completions 函数调用 | none 档位可用 | 工具调用改用 Responses |
| 文本与图片理解 | 文本、图片输入,文本输出 | 文本、图片输入,文本输出 |
| 上下文窗口/最大输出 | 1,050,000/128,000 token | 1,050,000/128,000 token |
| Standard 短上下文输入/输出单价 | 每百万 token 2/10 美元 | 每百万 token 2/10 美元 |
| 缓存读取单价 | 每百万 token 0.20 美元 | 每百万 token 0.10 美元 |
来源:GPT-6 Sol 官方规格、GPT-6.1 Sol 官方规格和 GPT-6 迁移指南。
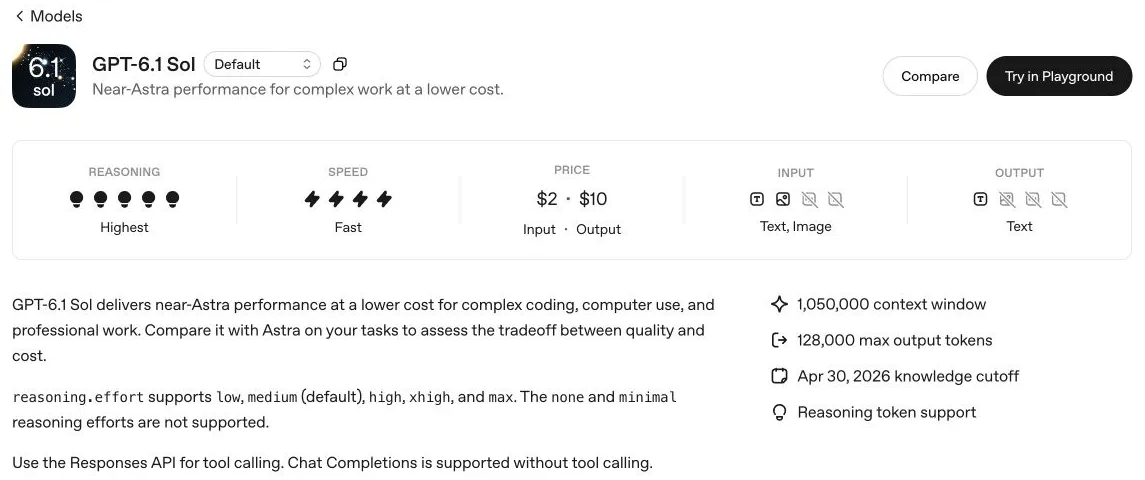
2026 年 9 月 30 日截取的 OpenAI 英文官方文档,保留原始界面语言。这张图用于核对规格,不是模型调用成功或性能实测截图。来源为上方官方规格链接。
迁移工作量取决于当前接法。已经使用 Responses 和 medium 的应用,可以先做一次受控的模型替换。如果现在使用 Chat Completions、函数定义和 none,只改模型名会留下两个不兼容点:推理档位无效,以及工具调用接口不对。先解决接口兼容,再比较答案质量,才能分清问题发生在哪一层。
创作场景还要分清能力边界。支持图片输入、文本输出,可以用来评审分镜,或检查图片中的文案;这不等于模型原生输出完整视频。官方列出的图像生成工具属于另一条工具执行链。对外承诺完整创作交付前,应确认实际调用路径和相应计费。
GPT-6.1 Sol 多少钱?怎么计算任务成本?
计算时应使用与你选择的服务模式相符的官方 API 价表。本文发布时,Standard 短上下文每百万 token 的价格为:普通输入 2 美元、缓存读取 0.10 美元、缓存写入 2.50 美元、输出 10 美元。这是 OpenAI 官方牌价,不是 Ofox 报价,也不是 ChatGPT 订阅费用。
只看单价,不能判断一项任务最终花多少钱。答案变长、推理增加、多一次工具往返或重试,都可能抵消缓存折扣。计算时必须把计费类别分开:缓存 token 不要再次按普通输入计算;如果总输出用量已经包含推理 token,也不要再把推理部分加一次。计费范围参见推理 token 文档。
假设你已经把本次请求的计费 token 正确分到互不重叠的类别中:
Standard 短上下文费用(美元)=
  (普通输入 × 2
   + 缓存读取 × 0.10
   + 缓存写入 × 2.50
   + 全部计费输出 × 10)÷ 1,000,000
三个可以复算的例子
下面是假设两代模型使用完全相同 token 数量的计算例子,不是实际账单,也不是对模型用量的预测。计算不含工具收费、税费、区域处理附加费和重试。
| 场景 | GPT-6.1 Sol | GPT-6 Sol | 说明 |
|---|---|---|---|
| 普通输入 20,000、输出 5,000 token,无缓存 | $0.090 | $0.090 | 基础输入、输出单价不带来节省 |
| 普通输入 10,000、缓存读取 100,000、输出 5,000 token | $0.080 | $0.090 | 相同用量下每次节省 $0.010,占这个例子总费用约 11.1% |
| 普通输入 300,000、输出 10,000 token,无缓存 | $1.350 | $1.350 | 整个请求按长上下文价格计算 |
第二行的算式为:0.01 × $2 + 0.10 × $0.10 + 0.005 × $10 = $0.08。缓存读取的单价降低 50%,不代表整次请求便宜 50%;在这个例子中,总费用只降低约 11.1%。如果执行 10,000 次完全相同的请求,则是 800 美元对 900 美元,尚未计入其他费用。实际输出长度一变,这个对比也会变化。
第三行超过了官方规定的 272,000 输入 token 门槛。输入超过该门槛时,整个请求的 Standard 输入和缓存费率变为短上下文的 2 倍,输出费率变为 1.5 倍。因此费用是 0.30 × $4 + 0.01 × $15 = $1.35,不能只给超过门槛的 28,000 token 加价。
Fast 价格为 Standard 的 2 倍;Batch 和 Flex 列出的价格为 Standard 的一半,但分别有适用范围和执行方式。先选择实际采用的价表,不要自行叠加折扣。对于缓存任务,还要单列符合计费条件的缓存写入;重复发送相同文字并不证明已经命中缓存。可以结合任务成本与缓存计算指南理解上一代 Sol 的统计方法,计算 6.1 时使用本文核对的新费率。
先迁移一个小流程,再切换生产环境
第一轮的目的,是把“请求能不能被正确处理”和“任务结果有没有价值”分开检查。先使用可丢弃的开发测试数据,不接真实客户交易。保留旧模型配置,让一次实验失败不至于变成紧急生产回滚。
第一步:记录已经正常工作的配置
保存旧模型 ID、接口、SDK 版本、实际生效的推理档位、系统指令、工具 schema 和脱敏后的测试输入。同时记录是否使用流式返回,以及应用如何识别最终结果。如果中间适配层会自动添加参数,要检查最终发出的请求体,而不只看业务代码。
第一次比较应保留新模型支持的原档位。原来使用 none 或 minimal 时,OpenAI 建议从 low 开始重新评估。low 可能改变延迟和 token 用量,不能当作等价的“关闭推理”。对于新模型,还应移除不兼容的 temperature、top_p、top_logprobs;Chat Completions 还要移除 logprobs,Responses 不应请求 message.output_text.logprobs。这些要求来自上方官方迁移指南。
第二步:发一个最小文本请求
准备当前版本的 OpenAI Python SDK、开发环境,以及已经开通计费并具有模型权限的 OpenAI API 项目。将 OPENAI_API_KEY 放入环境变量,通过 python -m pip install --upgrade openai 安装或升级 SDK。不要把密钥写进代码或共享终端记录。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENAI_API_KEY"],
    base_url="https://api.openai.com/v1",
)
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},
    input="Return only the result of 17 + 25.",
    max_output_tokens=4096,
)
print("model:", response.model)
print("status:", response.status)
print("answer:", response.output_text)
print("usage:", response.usage)
语义上的预期答案是 42。检查响应是否完成、返回的是不是指定模型、文本是否为空,不必把无关的空格差异当成失败。如果响应未完成,应查看原因和输出预算,不能直接记成迁移成功。示例中的输出上限只是便于说明,不代表任何任务的最佳配置。
验证范围:本文仅在本地检查了代码语法和模拟数据逻辑,没有付费执行 GPT-6.1 Sol 请求。 这里的预期答案是你运行时需要核对的验收条件,不是作者声称已经得到的实测结果。
第三步:验证一次完整的只读工具调用
模型返回函数调用,不等于函数已经执行。应用需要验证参数、执行被允许的操作,再把结果与对应的 call ID 一起发回。对于推理模型,续接时还要保留必要的响应输出项。官方函数调用指南说明了完整交互流程。
下列代码接在上面的 client 初始化之后。库存完全是本地虚构的示例数据,不访问真实商店:
import json

inventory = {"DEMO-001": 7}
tools = [{
    "type": "function",
    "name": "lookup_stock",
    "description": "Read stock from the local demonstration fixture.",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {"sku": {"type": "string"}},
        "required": ["sku"],
        "additionalProperties": False,
    },
}]
items = [{"role": "user", "content":
          "Use lookup_stock for DEMO-001 and report the available units."}]
completed = False
for _ in range(4):  # 示例保护上限,不是 API 限制。
    result = client.responses.create(
        model="gpt-6.1-sol",
        reasoning={"effort": "low"},
        input=items,
        tools=tools,
        max_output_tokens=4096,
    )
    if result.status != "completed":
        raise RuntimeError(f"Incomplete response: {result.status}")
    items.extend(result.output)
    calls = [x for x in result.output if x.type == "function_call"]
    if not calls:
        if not result.output_text:
            raise RuntimeError("No final text returned")
        print(result.output_text)
        completed = True
        break
    for call in calls:
        args = json.loads(call.arguments)
        if (call.name != "lookup_stock" or not isinstance(args, dict)
                or set(args) != {"sku"} or not isinstance(args["sku"], str)):
            raise ValueError("Unexpected tool or arguments")
        sku = args["sku"]
        payload = {"sku": sku, "units": inventory.get(sku)}
        items.append({"type": "function_call_output",
                      "call_id": call.call_id,
                      "output": json.dumps(payload)})
if not completed:
    raise RuntimeError("Tool loop exceeded the demonstration round limit")
检查调用记录:是否通过 lookup_stock 查询了 DEMO-001,返回结果是否包含库存 7,以及最终答案是否忠实使用了这个结果。即使答案碰巧猜中 7,只要没有按要求调用工具,这个测试也不算通过。 未知 SKU 返回 null,生产提示词和应用都应将其解释为“未知”,不能自动当成库存为零。
这个小示例遇到参数异常或响应未完成时会直接报错。正式应用还需要明确的错误处理、不含密钥的日志、取消机制及重试策略。如果工具会改变外部状态,必须避免重试导致重复操作,并在应用层执行权限检查;只在提示词里写一句要求,不能代替权限控制。更完整的接口背景可见 Responses 迁移指南。
第四步:检查流式返回和用户看到的完成状态
非流式测试正常后,再把同一组数据放进真实传输流程。检查文本片段是否只拼接一次、工具参数是否完整后才执行、取消是否阻止继续工作,以及界面能否区分“答案完成”和“响应中断”。加载动画消失,并不能证明操作成功。
给每次尝试保留 trace ID,并关联模型、推理档位、token 用量、耗时和结果。失败尝试也要记录,否则一次看似便宜的成功请求,可能掩盖前面多次付费失败。比较的是包含工具执行和结果验证的整项任务时间,而不只是首个 token 返回时间。
怎样判断是否值得切换?
准备一组团队能够独立判定对错的任务。下面是建议使用的评估表,不是本文的性能测试结果。每个重要类别先准备若干样本,包含已经知道的失败案例;扩大样本后,再决定能否推广到生产任务。
| 任务 | 测试输入 | 通过标准 | 需要认真对待的失败 |
|---|---|---|---|
| 代码维护 | 小型仓库、可复现的失败测试、范围明确的修改要求 | 补丁正确,相关测试通过,没有无关行为变化 | 只修表面症状,却破坏另一个场景 |
| 报告写作 | 含日期、冲突数字及未知负责人的工作记录 | 数字能追溯,指出冲突,保留未知项 | 虚构一个看似合理的数字或负责人 |
| 工具流程 | 已知及未知的库存 SKU | 调用、ID、结果使用和未知处理均正确 | 不调用工具就猜答案,或重复执行有副作用的操作 |
| 图片理解 | 脱敏截图及具体视觉问题 | 正确读取目标元素,看不清时说明不确定 | 回答流畅,却没有图片依据 |
对每组输入,用相同工具环境和评判规则比较新旧模型。条件允许时,审稿人先不看模型名称。对于结果不稳定的场景,重复运行多次。如果同时改了提示词、SDK 或推理档位,把它记录成另一组实验,否则很难知道收益来自哪里。
一份有用的评估记录应包含四项:尝试任务中有多少通过、包括失败尝试在内的 API 总花费、整项任务耗时,以及人工修正时间。运行前就定义“通过”。例如,报告格式再漂亮,只要虚构了收入数字就应失败;代码通过目标测试,但附带删除了无关功能,也不能算成功。
用 每个合格任务的成本=测得的全部花费÷合格任务数 来比较。如果没有任务通过,应写“没有合格结果”,不能除以零,也不能把这次执行描述成便宜。人工审稿时间先单列;如果要折算成金额,应注明采用的时薪假设。这样才能看清业务代价,不把 token 单价当成成品质量的替代指标。
上线阈值需要根据原有服务的错误率和延迟确定。可以依次做内部测试、少量低风险任务试用,再根据结果扩大范围。保留上一版模型配置;如果新路由违反预设验收条件,就回退受影响的部分,同时保留调用记录,区分模型表现和适配层问题。如果还要比较多个模型档位,可参考 Sol、Luna、Astra 任务选择指南。
第一次调用失败,先检查什么?
| 现象 | 优先检查 | 下一步 |
|---|---|---|
| 推理档位不支持 | 是否残留 none 或 minimal | 改为 low,重新运行同一组输入 |
| 工具请求被拒绝 | 是否仍发往 Chat Completions | 将完整工具循环迁移到 Responses |
| 采样参数报错 | SDK 适配层是否自动添加字段 | 从最终请求体移除不兼容字段 |
| 模型找不到或没有权限 | 精确 ID、API 地址、账号权限 | 核对服务商实际目录与凭据 |
| 答案为空或未完成 | 状态、输出预算、工具调用项 | 先检查响应,再决定是否重试或执行工具 |
| 缓存单价降低但账单更高 | 缓存命中、输出、上下文门槛、模式及重试 | 按真实计费类别重新计算 |
不要同时改完所有配置。保存不含凭据的失败请求体,每次只调整相关字段,再跑同一组数据。这样,无论问题发生在服务商还是自己的适配层,都能拿出可复现的证据。
建议从哪一步开始?
挑一个现有的 GPT-6 Sol 流程,确保你能判断它的结果是否正确。先确认权限,保留受支持的推理档位,解决接口兼容,再比较质量。最后依据真实用量和合格结果计算成本。GPT-6.1 Sol 的发布提供了尝试升级的理由,是否切换仍由这组验证决定。
使用 Ofox 时,先确认当前模型目录已列出精确的新模型与所需协议。在此之前,将官方直连示例和 Ofox 生产配置分开处理。本文的可用性及价格事实核验于 2026 年 9 月 30 日;以后接入时,请重新查看链接中的官方价表。
常见问题
- GPT-6.1 Sol 支持 none 推理档位吗?
- 不支持。可选 low、medium、high、xhigh、max。原来使用 none 的 GPT-6 Sol 应用,可以从 low 开始测试,但要重新评估延迟、费用和结果质量。
- GPT-6.1 Sol 能通过 Chat Completions 调用工具吗?
- 不能。工具调用需要使用 Responses API;不带工具的请求仍可使用 Chat Completions。
- GPT-6.1 Sol 比 GPT-6 Sol 更便宜吗?
- 官方 Standard 短上下文输入和输出单价相同,6.1 Sol 的缓存读取单价更低。整项任务是否省钱,还取决于实际 token 用量、重试、工具费用、上下文长度和服务模式。