Как добавить озвучку и субтитры в видеопроект Opus 5.5
Синхронизируйте закадровый голос и субтитры по предложениям в проекте Remotion, созданном с Opus 5.5. Готовые MP4, WAV, SRT и исходники, проверка тайминга и исправление рассинхрона.
 Ofox
Чтобы добавить озвучку и субтитры в видео Opus 5.5, относитесь к таймингу звука как к данным проекта. Создайте или запишите озвучку, измерьте её, сопоставьте каждое предложение с временной шкалой, затем отрендерите звук и субтитры вместе. Попросить модель «синхронизировать субтитры», не дав ей реального тайминга, недостаточно.
В этом руководстве используется тот же проект на реальных скриншотах, что и в нашем руководстве по демо продукта. Можно начать с его файлов для скачивания, не проходя сначала ту статью. Цель — 30-секундный MP4 с озвучкой, читаемыми субтитрами по предложениям, редактируемым источником тайминга и отдельным SRT, а не новая подборка промптов или непроверенное обещание автоматического дубляжа.
Посмотрите и изучите пример со звуком
Реальный экспорт Remotion с английским синтетическим эталонным голосом. Голос намеренно служит вспомогательным средством для проверки тайминга, а не демонстрацией профессионального качества озвучки. Субтитры выводятся целыми предложениями и включают паузы для чтения.
Скачайте полный проект, MP4 с озвучкой, эталонный WAV и английский SRT. Статьи на пяти языках используют этот общий английский пример; мы не выдаём его за пять локализованных аудиоверсий. Поэтому озвучка, субтитры и интерфейс в роликах остаются на английском.
В реальном вызове модели использовался claude-opus-5-5 в официальном Claude Code от Anthropic для генерации кода Remotion. Модель получила имена файлов и текстовые инструкции к сценам, а не пиксели изображений или аудиозапись. Затем мы добавили реальные исходные снимки, сгенерировали эталонный голос с помощью eSpeak NG, исправили код и отрендерили видео локально. Такое разделение труда — основа руководства: Opus написал код, синтезатор речи создал звук, Remotion собрал итоговый файл.
Выберите подходящий способ работы с таймингом
Есть две распространённые отправные точки. Если сценарий и длительность сцен ещё можно менять, сначала запишите или синтезируйте утверждённый голос, а затем подгоните визуальный ряд под его темп. Если видео должно уложиться в уже утверждённые 30 секунд, сначала задайте окна сцен и сократите любое предложение, которое в них естественно не помещается.
Наш пример идёт вторым путём. В нём пять готовых сцен и пять коротких предложений. Каждый аудиофрагмент должен уложиться в отведённое ему окно субтитра; скрипт эталонного аудио отклоняет фрагмент, выходящий за время окончания. Эта проверка ещё до рендера ловит реальный класс ошибок синхронизации.
| Исходный материал | Рекомендуемый подход | Главный риск |
|---|---|---|
| Утверждённая непрерывная озвучка | Измерьте или расшифруйте её, затем расставьте визуальный ряд и субтитры по реальной речи | Угадывание тайминга предложений по количеству слов |
| Видео продукта фиксированной длины | Напишите короткие предложения для каждой сцены; измерьте каждую запись | Скомканное или обрезанное предложение ради фиксированной склейки |
| Готовое видео с речью | Получите временные метки из реальной звуковой дорожки, затем проверьте их | Автоматическая расшифровка, принятая за проверенный файл субтитров |
| Многоязычная версия | Перезапишите и заново разметьте по времени каждый язык | Повторное использование английского тайминга, хотя длительность речи изменилась |
Документация Remotion по субтитрам описывает импорт, отображение и экспорт субтитров. В этом проекте намеренно используется небольшое JSON-расписание предложений, чтобы тайминг был на виду и легко проверялся. Автоматическая расшифровка и принудительное выравнивание (forced alignment) здесь не выполняются.
Начните с готового голоса, затем замените его
Установите Node.js и npm перед запуском проекта. Для необязательных проверок медиафайлов в терминале, описанных ниже, также нужна отдельная установка FFmpeg, включая ffprobe; npm ci эту консольную команду не устанавливает. Рендерить можно через готовые скрипты npm, не используя необязательные команды проверки.
Распакуйте архив и запустите проект из его корня:
npm ci
npm start
Выберите DemoNarrated. В архиве уже есть public/narration.wav, поэтому для рендера не нужно устанавливать синтезатор речи или покупать голосовой сервис. Проверьте первое предложение в начале, предложение о документации около 13-й секунды и последнее предложение около 27-й секунды.
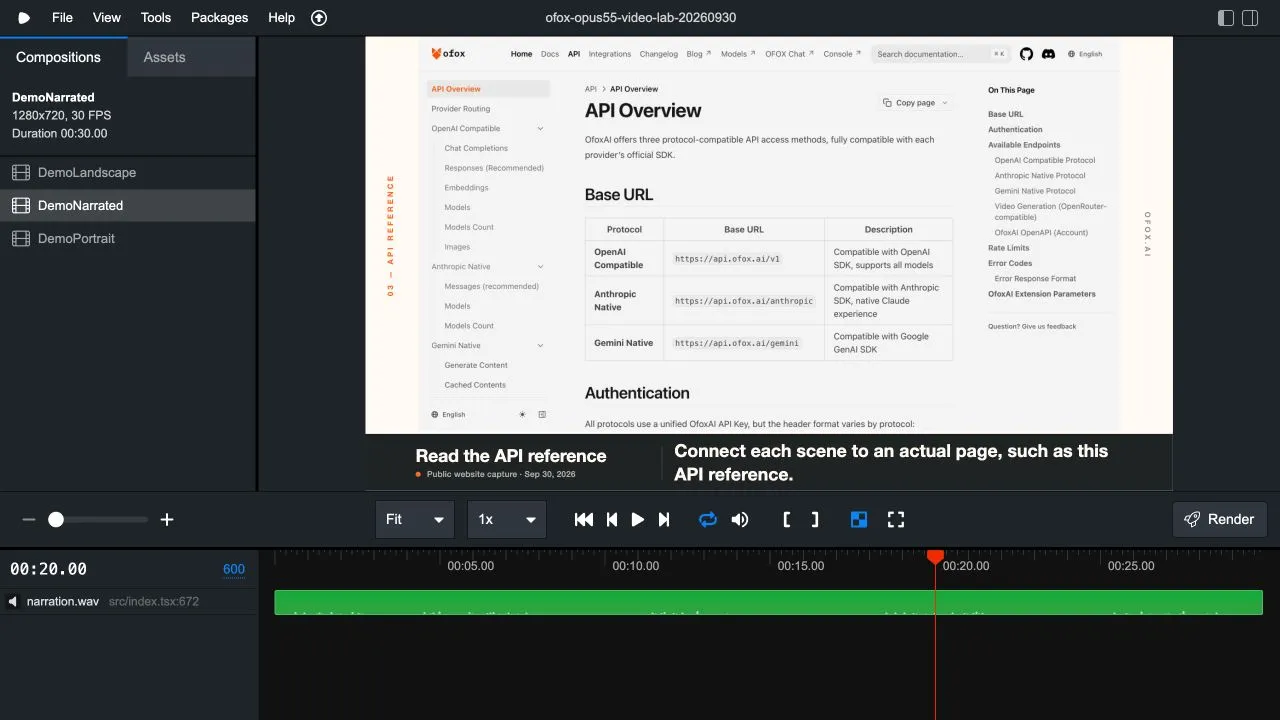
Реальное превью проекта со звуковой дорожкой WAV. Видимая волновая форма доказывает, что звук в проекте есть; качество произношения и выравнивание по словам она не подтверждает.
Чтобы воспроизвести эталонный голос, установите eSpeak NG способом, описанным в документации для вашей системы, и выполните:
python3 scripts/make_audio.py
npm run render:narrated
Мы использовали eSpeak NG 1.52.0, голос en-us и скорость 190 слов в минуту. Этот формантный голос намеренно звучит синтетически. Он удобен для проверки временной шкалы до выбора финальной озвучки; число — это настройка инструмента, а не гарантия одинакового темпа речи в каждом предложении.
Для готовой кампании используйте запись или синтезированный голос, который вы вправе публиковать. Прослушайте название продукта, аббревиатуры, паузы на знаках препинания и последнее слово каждого предложения. Правильная расшифровка не показывает, звучит ли голос естественно. Измеренные проверки в этой статье касаются длительности, расположения и видимых субтитров; это не оценка произношения или подачи человеком.
Одно расписание для WAV, субтитров и SRT
Откройте scripts/make_audio.py. Его массив LINES — эталонный источник: у каждой записи есть время начала, время окончания субтитра и текст. Скрипт создаёт 30-секундный WAV, src/captions.json, public/captions.en.srt и audio-timing.json. Композиция импортирует сгенерированный JSON, поэтому в коде видео не нужно вести второй, вручную редактируемый список субтитров.
Измеренные эталонные фрагменты приведены ниже. Предложения оставлены на английском, потому что именно они звучат в общей английской звуковой дорожке примера и совпадают с субтитрами в видео и в SRT.
| Предложение | Начало | Длительность фрагмента WAV | Конец фрагмента | Конец субтитра |
|---|---|---|---|---|
| A clear product video starts with a clear brief. | 0,35 с | 2,664 с | 3,014 с | 3,60 с |
| Show the real interface. Here, we begin with the model catalog. | 4,35 с | 3,681 с | 8,031 с | 9,80 с |
| Then show where a viewer can find the documentation. | 11,35 с | 2,917 с | 14,267 с | 16,80 с |
| Connect each scene to an actual page, such as this API reference. | 18,35 с | 3,743 с | 22,093 с | 23,80 с |
| Keep the message simple. Plan, build, and verify. | 25,35 с | 3,537 с | 28,887 с | 29,50 с |
Эти длительности включают хвостовые сэмплы сгенерированного фрагмента. Это не измерения отдельных фонем. Субтитры намеренно остаются на экране после окончания речи: у предложения о документации после его фрагмента WAV есть примерно 2,53 секунды дополнительного времени на чтение. Если нужен более плотный тайминг субтитров, сократите эту паузу, предварительно проверив реальную озвучку.
Скрипт добавляет тишину вокруг каждого фрагмента и ставит звук на указанное абсолютное время начала. Слишком длинное предложение он не ускоряет, чтобы втиснуть его в окно. Если исправленное предложение больше не помещается, явная ошибка подскажет, что его нужно сократить или сдвинуть время окончания до рендера.
Для непрерывной записи на замену нужен другой подготовительный шаг. Экспортируйте один полноразмерный public/narration.wav, затем отредактируйте src/captions.json и SRT под реальную запись. Не запускайте после этого make_audio.py, если не собираетесь перезаписать свою запись эталонным голосом. Храните исходную запись и сгенерированный пример в отдельных сохранённых версиях.
Аккуратно переводите секунды в кадры
Композиция работает с частотой 30 fps. Субтитр на 11,35 секунды попадает между кадрами видео. Итоговый код использует Math.floor(start * fps) для первого видимого кадра, поэтому это предложение появляется на кадре 340, примерно на 11,333 секунды, — чуть раньше, чем начинается голос. Плавного появления, которое могло бы скрыть первое произнесённое слово, нет. Короткое затухание происходит в последние шесть кадров.
const first = Math.floor(caption.start * fps);
const last = Math.round(caption.end * fps);
const visible = frame >= first && frame < last;
Это иллюстрация итогового правила видимости; полный компонент также задаёт компоновку текста и затухание в конце. Округление до кадров — ожидаемое поведение. Не заявляйте о выравнивании звука с точностью до сэмпла на основании визуальной шкалы 30 fps.
Готовый проект на Remotion 4.0.424 импортирует Audio из remotion и получает путь к WAV через staticFile. Текущая документация Remotion описывает этот более старый HTML5-компонент как Html5Audio и рекомендует для новых интеграций звука более новый медиакомпонент. При воспроизведении примера сохраняйте зафиксированные в архиве версии; не смешивайте изменение API из текущей документации с необъяснённым обновлением пакетов.
Читаемые субтитры без скрытых слов
Горизонтальная композиция отводит субтитрам тёмную полосу, отделённую от скриншота. В сценах документации и API заголовок сцены находится слева, а субтитр предложения — справа. В вертикальной версии изображение и субтитры расположены друг под другом; её геометрия описана в руководстве по вертикальному видео.
Наши английские субтитры набраны кеглем 28 пикселей в горизонтальной версии и 30 пикселей в вертикальной. Это значения проекта, а не универсальные правила соцплатформ. Выбранная длина предложений помещается в проверенные макеты. Более длинный перевод может не поместиться.
Исходный код модели ограничивал текст двумя строками через CSS line-clamping. Мы убрали это правило, потому что после правки оно могло незаметно скрыть третью строку. Правильное решение для слишком длинного субтитра — разбить или перефразировать его, увеличить место или изменить макет, а не делать пропавшие слова невидимыми.
Меняя текст, проверьте первый, самый длинный и последний субтитры в том размере, в котором их будут смотреть. Подстановка системных шрифтов может изменить переносы строк; архив не гарантирует одинаковую типографику во всех операционных системах. Если нужен фиксированный фирменный шрифт, включите в проект шрифт с подходящей лицензией, загрузите его перед рендером и повторите эти проверки.
Попросите Opus об ограниченной правке тайминга
Этот промпт для адаптации пригодится, когда вы уже измерили свою озвучку. Замените заполнители реальными значениями времени; это не дополнительный тест модели.
Обнови только существующую композицию DemoNarrated.
Сохрани утверждённые скриншоты, 30 fps и текущий порядок сцен.
Новая озвучка — public/narration.wav.
Вот измеренные интервалы предложений в секундах:
[вставьте начало, конец и точный произносимый текст]

Используй один источник данных для субтитров. Сохрани каждое произнесённое слово.
Показывай каждое предложение не позже его первого произнесённого слова; объясни округление до кадров.
Не выдумывай временные метки отдельных слов или результаты автоматической расшифровки.
Добавляй паузу для чтения только там, где я явно её указал.
Не используй line-clamping, чтобы скрывать переполнение.
Если предложение пересекает склейку сцены, укажи его, а не обрезай звук молча.
Верни изменённые файлы, допущения о тайминге и кадры для проверки.
После изменения сверьте текст с озвучкой, затем проверьте визуальный ряд. Если фраза описывает страницу API, а на экране ещё каталог, оба файла могут быть корректны по отдельности, но общая история неверна. Исправьте общее расписание сцен или запись; одним лишь смещением субтитров несовпадающую озвучку не исправить.
Экспортируйте и диагностируйте реальный файл
npm run render:narrated
ffprobe -v error -show_entries stream=codec_name,codec_type,duration,sample_rate \
  -show_entries format=duration -of json out/narrated.mp4
В отрендеренном примере есть видеопоток H.264 и аудиопоток AAC. Временная шкала видео — 30 секунд; сжатый звук может показывать немного иную длительность потока или контейнера из-за заполнения (padding) кодировщика. Наш эталонный WAV длится ровно 30 секунд. Проверяйте слышимое содержимое и синхронизацию, а не принимайте небольшой хвост AAC за ошибку длительности сцены.
| Симптом | Где вероятнее искать | Что менять |
|---|---|---|
| Весь MP4 без звука | Композиция, флаг mute, путь к WAV и метаданные потока | Используйте render:narrated, проверьте аудиофайл и убедитесь, что звук при рендере не был отключён. |
| Каждое предложение запаздывает на одну и ту же величину | Тишина в начале или общее смещение старта | Исправьте единое смещение и снова проверьте первое и последнее предложения. |
| Рассинхрон нарастает к концу видео | Неверные допущения о длительности, скорость звука или исходная шкала | Измерьте реальную запись; не подгоняйте каждый субтитр по угаданному числу слов. |
| Одно предложение пересекает склейку | Длительность этого предложения и граница сцены | Сократите или перезапишите его либо удлините сцену и весь зависимый тайминг. |
| На экране пропадают слова | Перенос текста и фиксированный блок субтитров | Разбейте предложение или измените размер макета; никогда не скрывайте переполнение. |
| В превью звук есть, а в итоговом экспорте нет | Итоговый файл и команда рендера | Проверьте аудиопоток MP4, а не только волновую форму в Studio. |
| SRT и вшитые субтитры различаются | Последний редактированный источник и порядок перегенерации | Перегенерируйте оба из одного расписания или при замене записи осознанно обновите оба. |
Перед сдачей воспроизведите весь экспортированный файл со звуком, проверьте начало и конец предложений и посмотрите версию, загруженную на вашу платформу публикации. Вшитые субтитры остаются видимыми в пикселях; отдельный SRT работает, только если платформа его поддерживает и он включён. Пример содержит оба варианта, но не утверждает, что какой-либо из них был загружен в соцсеть.
Отделяйте работу со звуком от доступа к модели
Карточка модели Opus 5.5 указывает модель, которая используется в этом процессе написания кода. Пример не подтверждает ни доступность TTS в Ofox, ни тарифицируемый рендер видео; зафиксированный вызов модели шёл через официальный Claude Code, а звук был создан локально.
Общий производственный путь описан в основном руководстве по видео с Opus, выбор исходников — в руководстве по демо из скриншотов, а перед переводом ролика в формат для мобильных устройств пригодится вертикальная адаптация. Надёжная передача включает итоговый MP4, WAV, соответствующий файл субтитров и точную версию проекта, из которой они получены.
Часто задаваемые вопросы
- Сгенерировал ли Opus 5.5 озвучку?
- Нет. Opus сгенерировал код видеопроекта. В этом примере используется явно синтетический эталонный голос eSpeak NG, а Remotion объединяет WAV с видео.
- Синхронизированы ли эти субтитры по словам?
- Нет. В примере пять субтитров по предложениям, выводимых по расписанию, с дополнительным временем на чтение после каждого аудиофрагмента. Подсветка по словам требует реальных временных меток слов и отдельной проверки.
- Можно ли заменить голос, не генерируя дизайн видео заново?
- Да. Замените аудио и обновите под него тайминг субтитров, сохранив утверждённый визуальный ряд. Если новая озвучка не укладывается в длительность сцены или проекта, перед экспортом пересмотрите общую временную шкалу.