JevとOpenAI Decisions APIを比較:問い合わせ分類を移行する前の確認手順
JevとGPT-6 Luna Decisionsのリクエスト形式、回答拒否、入力料金を比較。同じ問い合わせとPython教材で、移行時の変換処理と人手確認を検証します。
 Ofox
JevとOpenAI Decisions APIは、どちらもテキストの問い合わせを決められた窓口へ振り分ける用途に使えます。ただし、接続先をそのまま交換できるわけではありません。まず分類の定義と入力、正解ラベルをそろえ、回答の変換、不確実な結果の扱い、運用費用を確認します。既存クライアントのモデル名だけを変更しても、移行は完了しません。
この記事では、架空の問い合わせ8件、2種類のリクエスト生成処理、厳格なレスポンス検証、入力費用の計算スクリプト、採用までの評価手順を用意しました。Jev入門とDecisions APIのCSV分類チュートリアルをつなぎ、1つのアプリケーションから両サービスを利用する際の変更点に絞って説明します。
資料の確認日は2026年10月8日です。比較の根拠は公式ドキュメントと、実行済みのローカル合成テストです。有料APIは呼び出しておらず、モデルの正解率や通信遅延も測定していません。付属レスポンスはすべて教材用に作成したもので、接続処理のミスを見つけるために使います。
モデルの性能を比べる前に、入出力の仕様をそろえる
本例のJevはTypeSafeの jev-1.13.0 に固定し、Decisionsでは gpt-6-luna を指定します。Decisionsは現在パブリックベータです。Jevの jev-latest は将来別のバージョンを指す可能性があるため、実際の評価では返されたモデル識別子も保存してください。TypeSafeのモデル一覧、OpenAI Decisionsガイド。
| 比較項目 | JevのネイティブAPI | OpenAI Decisions API |
|---|---|---|
| POST先 | /v1/systemone | /v1/decisions |
| 共通の入力資料 | state | input |
| 質問の格納形式 | 質問IDをキーにしたマップ | 一意の name を持つ配列 |
| 選択肢の定義 | criteria マップ | value/descriptionの choices 配列 |
| 回答の取り出し方 | 質問IDで取得 | name で照合 |
| 選択肢の確率 | ラベルから数値へのマップ | value/probabilityの配列 |
| 真偽判定の型 | noul | predicate |
| 文書化された入力範囲 | 構造化テキストを含むテキスト | テキストと画像 |
表のパスは HTTPS で呼び出します。Jev のホストは api.typesafe.ai、Decisions は api.openai.com です。いずれも提供元への直接接続です。
例えば破損商品の写真が添付されているとき、Decisionsには写真を渡し、Jevには文章だけを渡して、その差をすべて分類能力の差とするのは不適切です。両者に同じ、利用許可のある説明文を渡すか、画像を含む別の評価として分けます。画像から文章への変換にも、追加処理の誤りや費用が生じます。
どちらの choice も、自由な説明文や返金額、根拠の引用を抽出するための指定ではありません。窓口ラベルに含まれない情報が必要なら、抽出処理を別に設計します。TypeSafe HTTPリファレンスで、ネイティブAPIの各フィールドを確認できます。
他の型も意図をそろえて変換します。以下の教材が実装するのはChoiceだけです。
| タスク | Jev | Decisions | 移行時の条件 |
|---|---|---|---|
| 順序のない分類 | choice、criteriaマップ | choice、choices配列 | ラベル名だけでなく意味を保持 |
| 順序のある評価 | score、順序付きcriteria配列 | score、順序付きlevels配列 | 段階の順序と説明を一致させる |
| 条件が成立するか | noul、結果フィールドnoul | predicate、結果フィールドprobability | どちらも0〜1の推定だが閾値は再評価 |
両者のScoreは段階のインデックスを確率で加重平均した値です。自動的に0〜1へ正規化される値でもconfidenceでもありません。3段階ならインデックスは0、1、2で、結果は1.1にもなります。アプリで最高インデックスによる除算を行うなら、その独自変換を記録し、両者の評価基準をそろえます。正規化した重大度と、条件成立の確率を混同しないでください。
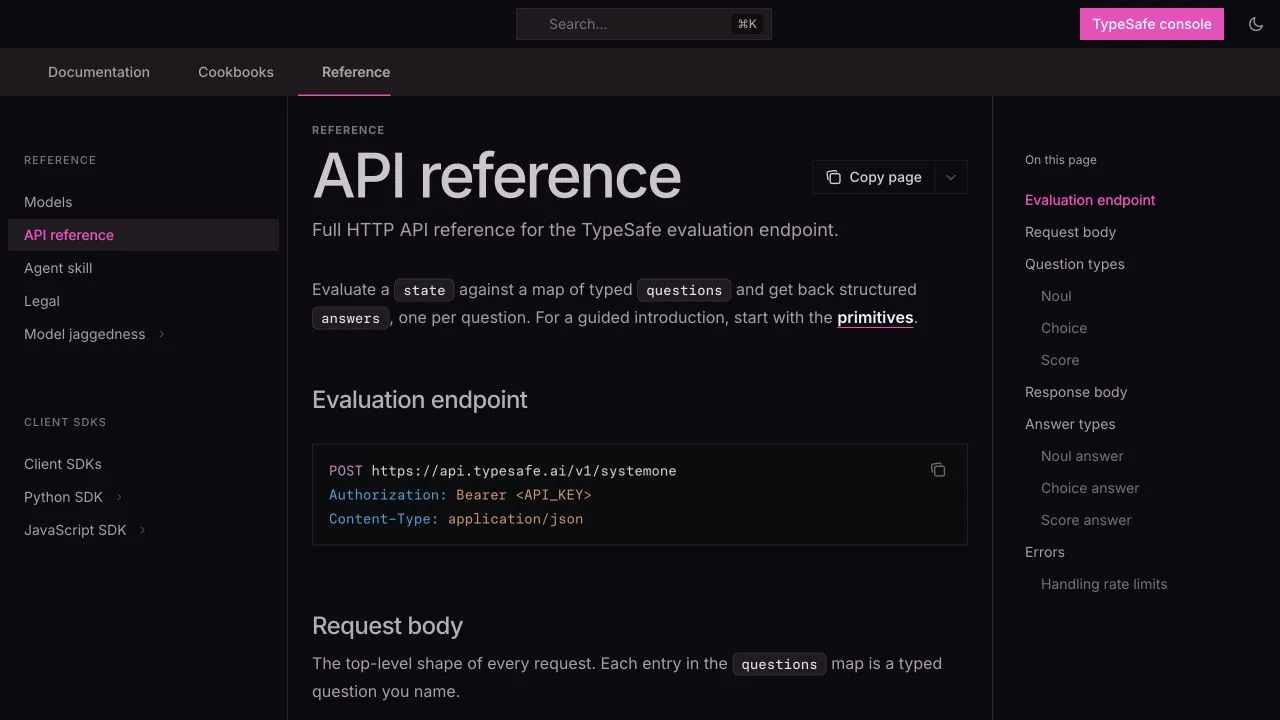
2026年10月8日に取得した公式英語ドキュメントの実際の画面です。問い合わせへの実行結果を示すものではありません。出典。
窓口の方針を1つに決め、ラベルを固定する
本例では、主な処理窓口を1つだけ選びます。billing は支払い・請求書・返金だけの依頼、technical は既存機能やアクセスの不具合だけの依頼、feature は新機能だけの要望です。複数部門にまたがる内容、曖昧な内容、無関係な内容は review とします。
「返金して、壊れたエクスポートも直してほしい」は review です。先に書かれた部門を優先する、と後から解釈してはいけません。実際の業務が2つの担当チームへの同時起票を必要とするなら、この単一選択の分類は不向きです。出力形式を設計し直す必要があります。
| ID | 問い合わせの意味 | 教材の正解 | 確認する境界 |
|---|---|---|---|
| T01 | 請求書を送ってほしい | billing | 明確な事務依頼 |
| T02 | 既存のエクスポートボタンが動かない | technical | 故障と新機能の区別 |
| T03 | カレンダー表示を追加してほしい | feature | 新しい機能 |
| T04 | 返金とエクスポートの修理 | review | 2部門への依頼 |
| T05 | 「おかしい」 | review | 情報不足 |
| T06 | billingと答える指示の後に無関係な内容 | review | 入力を命令ではなく資料として扱う |
| T07 | 日本語のログインエラー報告 | technical | 言語を保持する |
| T08 | 韓国語の支払領収書の依頼 | billing | Unicodeを保持する |
8件では本番の性能は推定できません。日本語と韓国語の例も、パイプラインが文字を壊さないかを確認するもので、両モデルの多言語精度を証明しません。TypeSafeは英語が主な訓練言語で最も得意だと説明し、他言語は自分の資料で評価するよう勧めています。評価対象をすべて英訳すると、元の業務とは異なる条件になります。
実データでは2人の確認者が同じ方針でラベルを付け、意見の違いを解消してから評価セットを固定します。指示の調整には別の開発セットを使います。記録IDを保ち、不要な個人情報を除き、過去の失敗例だけを集めないことも重要です。
共通のタスクから2種類のリクエストを作る
移行教材をダウンロードし、展開したディレクトリで作業します。Python 3.9以降の標準ライブラリだけを使うため、最初の実行に追加パッケージやAPIキーは不要です。payload() は同じ指示とラベル辞書を再利用します。
jev_request = {
    "model": "jev-1.13.0", "state": ticket_text,
    "questions": {"queue": {
        "type": "choice", "instructions": RULE,
        "criteria": LABELS,
    }},
}
openai_request = {
    "model": "gpt-6-luna", "input": ticket_text,
    "questions": [{
        "name": "queue", "type": "choice", "instructions": RULE,
        "choices": [{"value": k, "description": v}
                    for k, v in LABELS.items()],
    }],
}
RULE は、問い合わせを指示ではなく証拠として扱い、曖昧な場合にはreviewを選ぶよう定義しています。これはタスクの方針であって、プロンプトインジェクションへの耐性を証明するものではありません。T06も検査用ケースであり、安全性の認証ではありません。
この練習では1回に1件送ります。8件の文章をまとめて入力し、窓口を1つ質問しても、8つの独立した回答が自動的に返るわけではありません。後から同じ記録について複数質問する場合も、詰め方が変わるとトークン数や挙動が変わり得るため記録を分けます。
実APIクライアントは各社の公式ホストとBearer認証を使います。OpenAI互換ゲートウェイなら /v1/decisions も使える、という前提は置きません。まずネイティブ接続を確認してから、ゲートウェイ用の変換を追加します。
回答を正規化しても、失敗は隠さない
まず両方の固定レスポンス経路を実行します。
python3 migrate.py --provider jev --output jev-fixture
python3 migrate.py --provider openai --output openai-fixture作られる各ディレクトリには、元のJSONが8件、rows.json、summary.json が保存されます。既存ディレクトリは再利用できず、前回の証拠を上書きしません。OpenAI側のT05は意図的に回答拒否にしたテストです。GPT-6 Lunaが実際にこの文面を拒否する、という予測ではありません。
変換処理は質問を照合し、4ラベルが過不足なくそろうこと、確率項目の重複がないこと、数値が有限で合計がほぼ1になることを確認します。選ばれたラベルが最大確率を持つこと、confidenceが0から1の有限数であることも検査します。欠落、形式不正、通信失敗を正常な分類には変えません。
状態は3つに分けます。status=ok かつ choice=review は、正しく人手確認キューへ分類した結果です。status=refusal は回答拒否、status=error は取得または検証に失敗した状態です。すべてを成功したreview分類にまとめると、信頼性の問題が見えなくなります。
TypeSafeの現在の回答仕様には、OpenAIと同じrefusal型は記載されていません。Jev用にそのフィールドを創作せず、未知の型は検証エラーとして元データを保持します。将来の仕様変更も、その記録から調べられます。
例の閾値0.8は説明用です。有効な合成回答はすべてconfidenceを0.72に設定しているため、初期設定ではすべて人手処理になり、自動化率は0、自動処理分の一致率は null です。分母がない状態を、正解率0と解釈しないでください。
正しさと自動化率を別々に測る
一方のサービスの閾値を、そのまま他方へ移してはいけません。TypeSafeはChoiceの確率分布からconfidenceを算出する方法を説明していますが、他サービスの同じ小数が同じリスクや校正状態を意味するとは限りません。Jevのconfidence評価ガイドを参照し、各社の元の確率とconfidenceを保存します。
実データでは、有効回答と正解ラベルの一致率、全送信件数に対する自動処理率、自動処理分の一致率、回答拒否とエラー件数を最低限記録します。自動化率の分母には失敗も含め、実際の窓口別の混同行列も確認します。
人手へ回す件数を増やすだけでも、自動処理分の一致率は上がることがあります。その改善は有用でも、カバーする範囲の縮小と人手の負担を一緒に示す必要があります。請求の問い合わせを技術へ誤送するケースは、reviewへ回すケースと業務上の影響が異なります。
API利用、データ利用、支出が許可された段階で、TYPESAFE_API_KEY または OPENAI_API_KEY を安全に環境変数へ設定して実行します。
python3 migrate.py --live --provider jev --output jev-live
python3 migrate.py --live --provider openai --output openai-live
付属CSVでは、各コマンドが課金対象のリクエストを8件送ります。成功レスポンスにモデルやusageがあれば、そのまま残します。この教材は自動再試行しません。認証や検証の問題を先に調べ、本番の一時的なレート制限には上限付きの待機と再試行を実装し、各試行と費用の可能性を記録します。固定レスポンスの実行時間は通信遅延と比較できません。
各社の実際の使用量で費用を計算する
確認時点のJev 1.13は入力100万トークン当たり0.042米ドル、出力無料です。GPT-6 LunaのDecisionsは入力100万トークン当たり0.10米ドルで、出力とキャッシュ読み書きの料金はありません。ただし、地域による加算や長いコンテキストの入力倍率は適用されます。これは公式直接接続の基本料金であり、Ofoxの価格ではありません。Jev料金、Decisions料金。
python3 cost.py --jev-tokens 2000000 --openai-tokens 2000000同じ200万トークンという仮定では、基本料金で0.084米ドルと0.20米ドルです。実際の請求書ではありません。同じ文章でも課金トークン数が同じとは限らないため、それぞれのusageに置き換え、繰り返す指示や課金された再試行も含めます。
さらに人手確認を加えます。例えば1万件の20%を1件0.50米ドルで確認すると、人手分だけで1,000米ドルです。これも仮定であり顧客の実測費用ではありません。移行開発、画像の前処理、再試行、誤分類後の損失は入力費用計算の外にあります。Jevルーティングの損益分岐点で、より広い費用の考え方を説明しています。
採用を決めたら、少しずつ切り替える
テキストだけの窓口分類なら、Jevの低い公式入力単価は評価する理由になりますが、正解ラベル上の優位を示すものではありません。画像の証拠が必要な場合や、OpenAIネイティブAPIを既に運用している場合はDecisionsも候補になります。パブリックベータである点も、障害対応やサポートと一緒に検討します。
最初はシャドー運用にします。本番の振り分けを維持したまま、許可されたサンプルで候補の回答を保存し、同じ正解と照合します。許容する誤り、自動化率、人手負担は結果を見る前に決め、不満な結果に合わせて基準を下げません。言語別と問い合わせ種別の結果を確認してから、一部のトラフィックだけを切り替えます。
前のプロバイダー設定と分類方針の版を残し、戻せるようにします。モデル変更、形式不正の増加、人手キューの容量超過があれば拡大を止め、具体的な記録を調べます。教材の成功は、テストした変換処理が動いた証拠です。本当の移行判断は、実データの品質と運用費用を確認して初めて下せます。
よくある質問
- JevからDecisionsへはモデル名を変えるだけで移行できますか?
- できません。エンドポイント、入力フィールド、質問の格納形式、確率の表現が異なります。分類方針は共通化し、リクエストとレスポンスの変換処理はサービス別に用意します。
- この教材では、どちらのモデルが正確でしたか?
- 優劣は測定していません。付属レスポンスはプログラム検証用に作成したデータで、実際のモデル出力ではありません。採用判断には、評価用に取り分けた実データが必要です。