Jevのベンチマークを読む:評価結果から分かることと限界
Jevの独立評価を読み解き、分類性能とエージェント全体の性能を区別します。モデル選定に使える評価シートと、比較時に確認すべき条件を解説します。
 Ofox
Jevの新しいベンチマークは、選択肢が限定された分類やルーティングの判断に向けて、同モデルを評価候補に加える材料になります。ただし、汎用LLMを置き換えられること、confidenceの数値が正しさを保証すること、エージェントに組み込めば必ず安くなることを示したわけではありません。確認すべきなのは、必要な判断が、実際に測定されたタスクにどれほど近いかです。
この記事は、TypeSafe AIのJevをワークフローに組み込むか検討している開発者向けです。公開された結果と、そこから導く実務上の解釈を区別し、実装に費用をかける前に記入できる評価計画を用意しました。本記事のために論文の実験を再実行したり、Jevの実APIで推論したりはしていません。APIの基本は、Jevの概要と設定ガイドから確認してください。
まず、何と何を比較するのかを決める
問い合わせを窓口に振り分ける分類器、許可されたツールを選ぶエージェント、顧客への返信を作るモデルは、それぞれ別の仕事をします。正しい窓口を選べても、返信を書くには別の仕組みが必要です。同様に、ツール名を選べたことだけでは、引数が正しいこと、呼び出し元に権限があること、処理が成功したことは分かりません。
必要な判断を、この入力から、この出力候補のいずれかを選び、間違えた場合にはこの影響が生じるという仕様にしてください。自由な文章、新しいプログラム、画像、動画が必要なら、Jev単体を評価しても目的に合いません。残りの処理を担う生成モデルや決定論的なコードも含め、アプリケーション全体を評価します。
| 必要な判断 | 有用な測定項目 | 代わりに使うと誤解を招く指標 |
|---|---|---|
| 問い合わせを請求、技術サポート、人による確認へ振り分ける | 自社の問い合わせにおけるクラス別誤りと自動振り分け率 | 一般知識クイズの得点 |
| 許可されたツールを選ぶ | 選択肢としての妥当性、選択の正しさ、権限、実行結果 | JSONとして解析できたという事実だけ |
| 検索で得た文章を絞り込む | 必要な根拠の保持率と最終回答の品質 | 商品推薦のランキング結果 |
| 別のモデルや担当者へ引き継ぐか判断する | 自動処理した事例の誤り、引き継ぎ先の品質、総費用 | 高価なモデルの呼び出しを減らした割合だけ |
これは評価基準の提案であり、Jevの実績を示す表ではありません。この基準を先に決めると、公開研究のどの部分が自分の用途に関係するかを判断できます。
独立ベンチマークから得られる材料
9月29日の独立したプレプリントは、jev-1.13.0を37データセット、346,009リクエストで評価し、Qwen3.8-27BおよびGemma-4-E4Bも比較しています。これは公開研究であり、当サイトが再現した結果ではありません。論文と公開資料を参照してください。
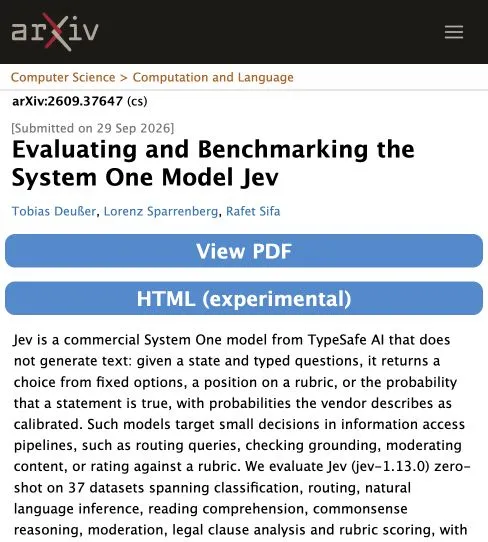
2026年10月2日に撮影した英語の原典ページです。取り上げている研究を示すもので、Ofoxによる実験の画面ではありません。
公開評価は、判断用モデルを詳しく調べるきっかけとして扱います。そのまま本番導入の承認になるわけではありません。性能が役立つかどうかは、自社の入力母集団と合格基準で決まります。
論文と併せて、著者のコードリポジトリも確認してください。結果を引用する前に、データの分割、リクエストのテンプレート、質問型、モデルのバージョン、評価指標、不確実性の区間を特定します。これらを切り離した表の数値は、自分のシステムとは別の問いに答えている可能性があります。
得点と苦手な条件を併せて読む
以下は、論文で固定されたリクエストに対する結果です。正解率、バランス正解率、F1は異なる指標なので、行をまたいでタスクの優劣を順位付けすることはできません。
| データセット・比較内容 | 報告された結果 | 実務での読み方 |
|---|---|---|
| Banking77、77種類の意図分類 | 正解率79.7% | 自動振り分けの前に、意味が近い意図同士をテストする |
| CLINC150、対象外の選択肢を含む | 正解率89.5% | 自分の評価データにも対応対象外の問い合わせを含める |
| Belebele、122言語を合算 | 正解率86.7% | 合算した得点では、特定言語の利用可否を判断できない |
| LLM-AggreFact | バランス正解率78.6% | この根拠整合性データセットでの証拠であり、一般的な真偽判定の保証ではない |
| UNFAIR-ToS | yes確率の閾値0.5でMicro-F1が0.499、調整後の閾値で0.748 | 閾値の選択によって二値判断の方針が変わる |
| AGB-DE | F1が0.204、閾値調整でも変わらず | 閾値の変更ではなく、判別能力の改善が必要な失敗もある |
UNFAIR-ToSで調整したのは、Noulのyes確率の閾値であり、Choiceのconfidenceではありません。QwenとGemmaはthinkingを使わず、Jev向けのテンプレートで実行されています。各リクエストの実行は1回です。MMLUに関する追加検証でも、質問と回答の組を記憶していた可能性は排除されていません。プレプリントの表2・4と制約の節を確認してください。
組み込みを判断するときは、得点と同じくらい、こうした条件が重要です。短時間で選択肢から分類する実験と、難しい問題について推論する時間を与えたモデルの評価は、別の利用形態を扱っています。再実行時の安定性、対象言語での性能、間違えた場合の損失が大きい事例は、主要な表に載っていなくても自社の評価に含める必要があります。結果の原因が未解明であることを、データ汚染の証明とも、推論能力の証明とも扱わないでください。
「Jev対Qwen」だけでは選定が決まらない理由
少なくとも3種類の比較があり、それぞれ導入判断が変わります。1つ目は、同じ限定された回答候補から選ぶ能力の比較です。2つ目は、同じ合格条件を満たす成果物を作るアプリケーション全体の費用です。3つ目は、ホスティング、再現性、データを環境の外へ送れるかといった運用条件です。
1つ目の分類スコアと2つ目のチャット生成価格を組み合わせて、万能な勝者を決めてはいけません。セルフホストには、ホスト型APIのトークン価格に含まれないハードウェア、稼働率、保守の費用があります。一方、ホスト型の判断APIが、ローカル環境で必要な制御をすべて提供するわけでもありません。
比較表は、完結したタスクごとに1行を設けると役立ちます。入力母集団、実際のバージョン、許可する出力、品質基準、再試行、遅延、課金された総額を記録してください。必要な出力をモデルが扱えない場合は、低い品質点を付けるのではなく、タスクとの不適合として明記します。機能自体がないことと、同じ機能の性能が劣ることを混同しないためです。
型が正しくても、判断の意味が正しいとは限らない
別の論文では、選択肢の名前と、その名前に結び付ける判定基準の対応を入れ替えています。ホスト型Jevの結果にも、その変更に対する感度が見られました。実務上の要点は、返されたラベルが形式上有効でも、意図した意味に従って判断したとは限らないことです。この論文は他のモデル系列も扱っているため、それらの大きな影響量をJevの数字として紹介してはいけません。選択肢名を扱った研究の第2版を参照してください。
ホスト型Jevでは、1,200問でyes/noの名前と定義の対応を入れ替えると、判断の32.5%が変わりました。中立的な0/1を使った対照条件では2.08%でした。これより大きい76.92%というyes/noの反転率は、JevではなくLayaの数値です。この実験は名前と定義を意図的に食い違わせたものであり、通常のJevリクエストの32.5%が失敗するという推定ではありません。前述のベンチマークで回答の位置だけを回転させる検証とも異なります。
例えば、手動確認が必要な事例を説明する基準に、approveというラベルを付けたとします。アプリケーションは返されたラベルどおりに動いていても、質問の設計そのものに問題があるかもしれません。名前と説明を矛盾させず、本番コードが使う対応関係をそのままテストしてください。評価後にラベルを翻訳したり、基準の順序や選択肢名を変えたりする場合は、回帰テストが必要です。
有用なテストセットには、通常の事例、判断の境界に近い事例、情報不足の入力、判定基準よりラベル名に引きずられやすい事例が含まれます。人工的な敵対的テストデータと、自然に発生するトラフィックは分けて扱ってください。どちらも必要ですが、作為的なストレステストを、日常的な誤りの頻度の推定に無断で置き換えてはいけません。
エージェントの効率は処理全体で測る
REFLEXの研究は、限定された判断をJevに任せ、必要に応じて強力なモデルへフォールバックする設計を評価しています。制御された環境での効率改善を報告する一方、外部評価では安価な生成モデルのカスケードに対する利点が限られることも示しています。この反例を踏まえ、高価な強力モデルだけを使う構成に加え、実際に導入候補となる経済的な代替案とも比較してください。REFLEX論文を参照できます。
自分のシステムでは、どの構成でも同じ合格基準を最終結果が満たしたときだけ、タスク成功と数えます。すばやく経路を選べても、最終回答が間違っている可能性はあります。フォールバックは信頼性を上げる一方、時間やトークンを追加し、新たな失敗機会を生みます。ツールエラー、空の応答、再試行したリクエストも、報告から消さずに母数へ含めてください。
ルーティング費用ガイドには比較用の計算ツールがあります。実測値があればそれを使い、例示用の単価は仮定として扱います。confidence評価ガイドでは、候補となる閾値で実際にどれだけのトラフィックを自動処理できるかを測定します。
チームで再現できる評価を組み立てる
評価シートとオフライン判断キットをダウンロードしてください。CSV形式のシートには、以下の判断事項を記録します。これはモデル順位表ではなく、合格条件を第三者が確認できる形にするためのものです。
- 対象母集団を定義する。 どのリクエストを実験に入れるかを書きます。実際の言語、文書の長さ、曖昧な事例を含めてください。難しい入力を除外すると、主張できる範囲も変わります。
- ラベル付け基準を書く。 モデルの回答を見ずに、人が元資料からラベルを付けます。不一致を解消し、根拠から判断できない場合は、不確実という区分を残します。
- 情報が漏れ得る単位で分割する。 同じ顧客の会話、関連文書、ほぼ同じテンプレートは同じ分割に入れます。行単位の無作為分割では、調整用と最終評価用に非常によく似た事例が入ることがあります。
- システムを固定する。 モデルID、質問文、ラベル、フォールバック規則、前処理を記録します。モデル名が同じでも、質問が変われば実験が変わります。
- 代替案を同じ入力で評価する。 可能ならルールベース、安価なモデルのカスケード、現行システムを含めます。合格基準と測定範囲はすべてそろえます。
- 平均値を採用する前に誤りを見る。 まれでも損失の大きい間違いを切り分けます。全体の正解率が高くても、ほとんど機能しない振り分け先が隠れていることがあります。
- 自動実行の前にシャドーモードで動かす。 実際の処理は既存の経路に任せ、候補となる経路だけを記録します。未検証の判断で重大な副作用を起こさず、結果と費用を比較します。
最終的には、何を自動化し、何を引き継ぎ、どの入力を未対応とし、何をロールバック条件とするかを短い判断記録にまとめます。「平均が改善した」だけでは、対象母集団と失敗の境界が分かりません。
手元の結果が論文と違うとき
最初に、同じタスクを測っているかを確認します。次にモデルのバージョン、入力表現、選択肢の文言、言語構成、採点基準を比較してください。公開ベンチマークと本番サンプルが異なる母集団を扱っていれば、両者が正しく測定されていても結果は違います。
正解率は十分でも自動処理率が低い場合は、1つの質問に複数の判断を詰め込んでいないか、重要な文脈が欠けていないかを調べます。高confidenceの誤りが続くなら、処理量を増やすために閾値を下げるより、該当事例を個別に確認してください。判断は正しくても最終タスクが失敗する場合は、その先の処理やフォールバック経路に注目します。
期待外れの結果から、モデル全体に価値がないと結論付ける必要はありません。「このバージョンと質問設計では、このタスクの合格基準を満たさなかった」と範囲を限定します。逆に、1つの振り分けテストで成功しても、別の言語、ツール、ワークロードが検証されたことにはなりません。
次に確認すること
回答候補が限定され、その判断によって残りの処理を実際に減らせる場合、Jevは評価候補になります。公開ベンチマークは実験を選ぶために使い、実験を省くためには使わないでください。実際のタスクに生成が必要なら、Jevを1つの部品として評価し、最終出力、総費用、失敗時の挙動を併せて見ます。
まず評価シートの品質基準とフォールバック方針を埋めてください。この2点を決めると、続く閾値テストに意味が生まれます。見栄えのよいベンチマーク結果を、別の問題を解くために買ってしまうことも避けやすくなります。
よくある質問
- Jevのベンチマークは、LLMを置き換えられることを示していますか?
- いいえ。評価対象は選択肢が限定された判断であり、汎用的な文章生成やコーディング全体ではありません。タスク、インターフェース、比較対象、評価方法をそろえて選定する必要があります。
- これはOfoxが実施したJevの実測ですか?
- いいえ。公開研究と公式ドキュメントの分析です。付属シートは独自の評価計画を作るための資料であり、新しいモデル実験の結果ではありません。