Images API
Zwei Endpunkte: Generieren (Text → Bild) und Bearbeiten (Bild + Text → Bild). Die Antworten folgen der OpenAI-Standardstruktur data[0].b64_json.
| Was du tun möchtest | Endpunkt | Unterstützte Modelle |
|---|---|---|
| Ein Bild aus Text generieren | POST /v1/images/generations | openai/gpt-image-2, google/gemini-3.1-flash-image, bailian/qwen-image-3.0-pro |
| Ein Bild hochladen und per Anweisung bearbeiten | POST /v1/images/edits | Nur OpenAI / Azure: openai/gpt-image-2, openai/gpt-image-1.5 |
Zwei Ausnahmen bei Bild-zu-Bild: Die Qwen-Reihe nutzt dafür das Feld input_images von generations, nicht edits; die Gemini-Reihe kann an keinem der beiden Endpunkte dieser Seite bearbeiten — nutze dafür das native Gemini-Protokoll.
Anbieter festlegen
provider.type bindet die Anfrage an einen Anbieter. Sinnvoll ist das nur bei Modellen, die von mehreren bereitgestellt werden — heute openai/gpt-image-2 (azure_foundry und openai). Einen Anbieter anzugeben, der das Modell nicht bereitstellt, liefert 400 provider_type_unavailable.
| Anbieter | Beschreibung | Inhaltsmoderation |
|---|---|---|
azure_foundry | Auf Microsoft Azure gehostet | Strenger |
openai | OpenAIs eigene API | Freizügiger |
Die beiden Anbieter von openai/gpt-image-2 moderieren nicht nach demselben Maßstab: azure_foundry ist strenger, openai freizügiger. Gib provider.type: "openai" ausdrücklich an, wenn ein Prompt wiederholt abgelehnt wird — sonst kann die gewichtete Verteilung auf azure_foundry führen.
Vollständige Referenz: API · Provider-Routing.
Text zu Bild — /v1/images/generations
/v1/images/generations nimmt einen JSON-Body entgegen — sowohl das Body-Feld als auch der Header funktionieren.
Python
resp = client.images.generate(
    model="openai/gpt-image-2",
    prompt="A simple red apple on a white table",
    size="1024x1024",
    extra_body={"extra_body": {"provider": {"type": "openai"}}},
)Bei den offiziellen OpenAI-SDKs muss extra_body als wörtlicher Schlüssel im Request-Body vorhanden sein. Das TypeScript-SDK sendet es so, wie es im Parameterobjekt steht. Das Argument extra_body= des Python-SDK verschmilzt seinen Inhalt mit der obersten Ebene des Bodys; der Schlüssel muss dort also eine Ebene tiefer verschachtelt oder stattdessen als Request-Header übergeben werden.
Bildbearbeitung — /v1/images/edits
/v1/images/edits ist ein Multipart-Upload; es gibt keinen JSON-Body, in dem extra_body verschachtelt werden könnte, daher wirkt hier nur der Header. Als Formularfeld übergebenes extra_body wird ignoriert und die Anfrage läuft ohne Einschränkung durch.
curl https://api.ofox.run/v1/images/edits \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "X-OfoxAI-Provider-Type: openai" \
  -F "model=openai/gpt-image-2" \
  -F "prompt=..." \
  -F "image=@input.png"
Bei /v1/images/edits wird ein als Formularfeld gesendetes extra_body still ignoriert — das Bild entsteht ohne die Einschränkung. Nutze X-OfoxAI-Provider-Type.
Bilder generieren
POST https://api.ofox.run/v1/images/generationsParameter
| Parameter | Typ | Pflicht | Beschreibung |
|---|---|---|---|
model | string | ✅ | openai/gpt-image-2, google/gemini-3.1-flash-image, bailian/qwen-image-3.0-pro |
prompt | string | ✅ | Beschreibung in natürlicher Sprache |
quality | string | ✅ | auto / low / medium / high / standard / hd |
n | number | — | 1–10, Standard 1. Von Gemini-Modellen nicht unterstützt |
size | string | — | auto / 1024x1024 / 1536x1024 / 1024x1536 / 256x256 / 512x512 / 1792x1024 / 1024x1792 |
input_images | string[] | — | Array von Referenzbildern (URL oder Base64), 1–3, von Qwen-Bildmodellen unterstützt; wenn wirksam, enthält die Antwort usage.num_input_images |
output_format | string | — | png / jpeg / webp |
background | string | — | transparent / opaque / auto |
stream | boolean | — | Standard false |
extra_body.provider.type | string | — | Bindet die Anfrage an einen Anbieter. Nur sinnvoll bei Modellen, die von mehreren Anbietern bereitgestellt werden (an diesem Endpunkt derzeit openai/gpt-image-2); der Header X-OfoxAI-Provider-Type ist gleichwertig |
Antwort
{
  "created": 1777385517,
  "data": [
    { "b64_json": "<Bild Base64>", "index": 0 }
  ],
  "model": "openai/gpt-image-2",
  "size": "1024x1024",
  "quality": "low",
  "usage": {
    "input_tokens": 14,
    "input_tokens_details": { "text_tokens": 14 },
    "output_tokens": 208,
    "total_tokens": 222
  }
}
Das Bild liegt in data[0].b64_json; einfach Base64-dekodieren und speichern.
OpenAI-Reihe (gpt-image-2)
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.run/v1")

resp = client.images.generate(
    model="openai/gpt-image-2",
    prompt="A simple red apple on a white table",
    size="1024x1024",
    quality="low",
    output_format="png",
    # Optional: einen Anbieter festlegen. Ohne das Feld routet die Plattform selbst
    # extra_body={"extra_body": {"provider": {"type": "openai"}}},
)

with open("output.png", "wb") as f:
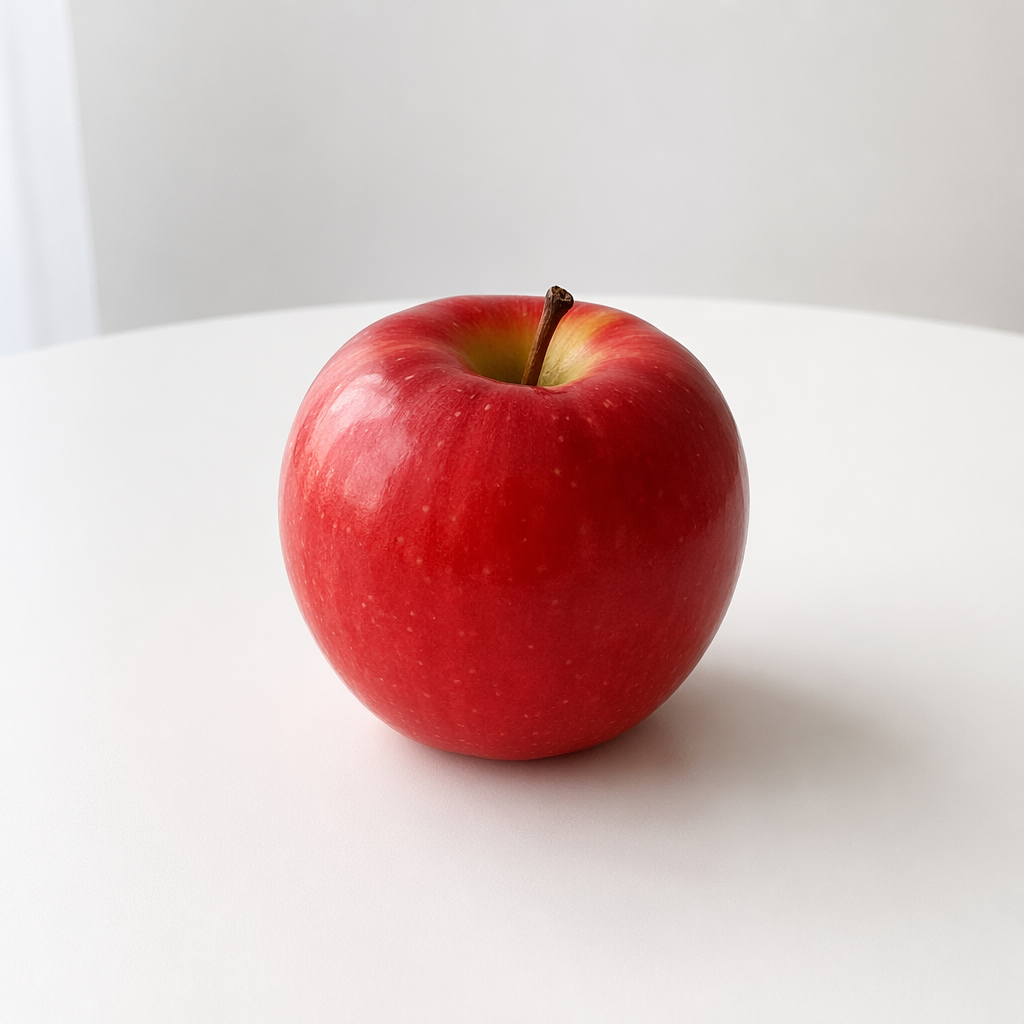
f.write(base64.b64decode(resp.data[0].b64_json))Tatsächliches Ergebnis:
Gemini-Reihe (gemini-3.1-flash-image)
Derselbe Endpunkt akzeptiert auch Gemini-Bildmodelle. Übergib n nicht — das Gateway mappt n fälschlicherweise auf das Feld numberOfImages und gibt 400 zurück; pro Aufruf wird genau 1 Bild erzeugt.
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.run/v1")

resp = client.images.generate(
    model="google/gemini-3.1-flash-image",
    prompt="A simple red apple on a white table, photorealistic",
    size="1024x1024",
    quality="low",
    output_format="png",
)

with open("output.png", "wb") as f:
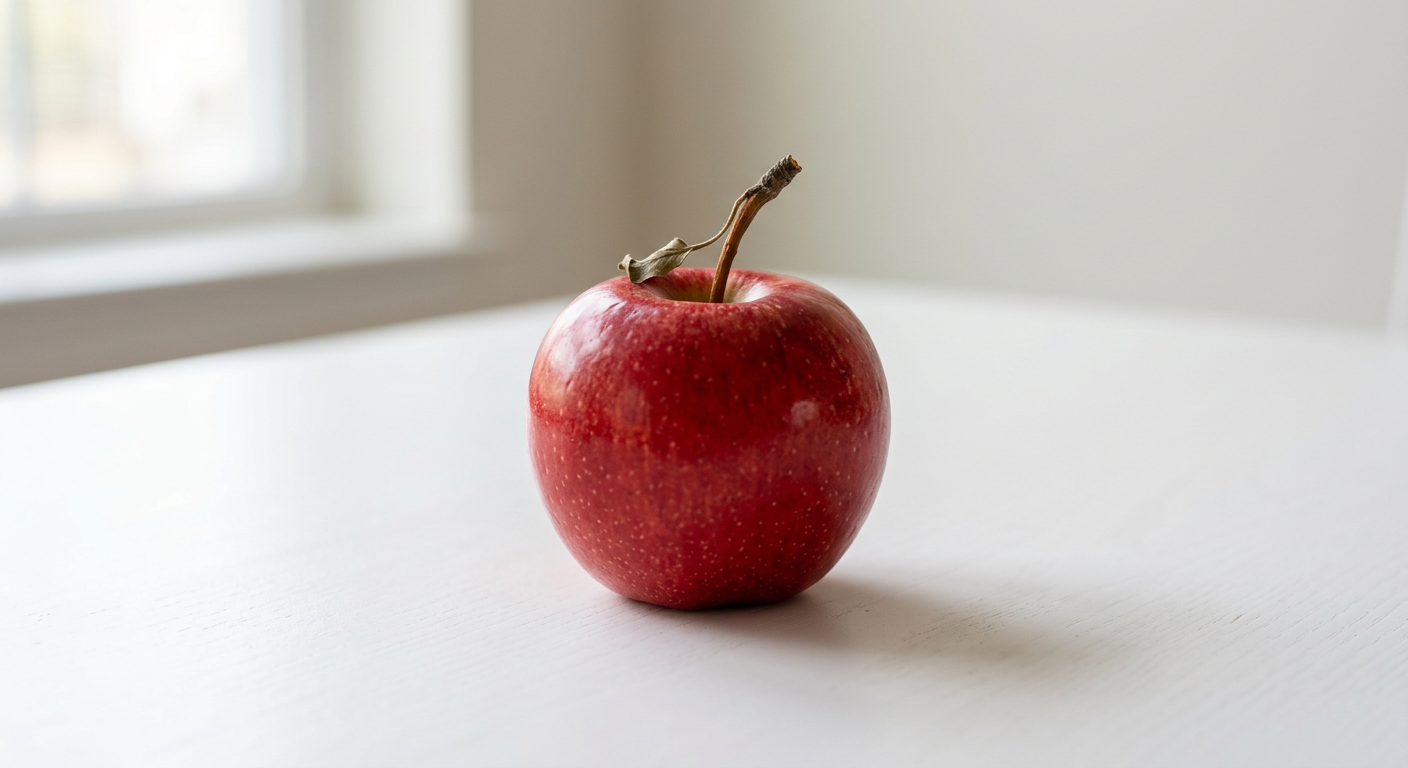
f.write(base64.b64decode(resp.data[0].b64_json))Tatsächliches Ergebnis:
Qwen-Reihe (qwen-image-3.0-pro)
Qwen-Bildmodelle wie bailian/qwen-image-3.0-pro nehmen Referenzbilder für Bild-zu-Bild und Bearbeitung direkt an diesem Endpunkt entgegen (1–3 Bilder), über das Feld input_images (jedes Element ist eine Bild-URL oder ein Base64-String):
curl -X POST 'https://api.ofox.run/v1/images/generations' \
  -H 'Authorization: Bearer YOUR_OFOX_API_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "bailian/qwen-image-3.0-pro",
    "prompt": "Färbe den Apfel blau, lass alles andere unverändert",
    "size": "1024x1024",
    "input_images": ["https://example.com/ref-apple.png"]
  }'
Wenn Referenzbilder greifen, enthält die Antwort unter usage das Feld num_input_images (Anzahl der Eingabebilder) — damit lässt sich programmatisch bestätigen, dass das Modell sie gelesen hat.
Das Feld muss input_images heißen. Andere Schreibweisen wie image_urls, image oder images werden stillschweigend ignoriert, die Anfrage fällt auf reines Text-zu-Bild zurück (HTTP bleibt 200).
Bilder bearbeiten
POST https://api.ofox.run/v1/images/editsmultipart/form-data, eine Bilddatei muss hochgeladen werden.
Dieser Endpunkt unterstützt ausschließlich OpenAI- / Azure-OpenAI-Modelle. Ein Aufruf mit google/gemini-3.1-flash-image liefert Image editing is not supported for model zurück — nutze stattdessen Bildbearbeitung über das native Gemini-Protokoll.
Parameter
| Parameter | Typ | Pflicht | Beschreibung |
|---|---|---|---|
model | string | ✅ | Empfohlen openai/gpt-image-2 |
image | file | ✅ | PNG- / JPEG-Datei, max. 15 MB pro Datei, bis zu 16 Bilder pro Anfrage, 50 MB Gesamtgröße des Request-Bodys. Halten Sie jede Datei nach Möglichkeit unter ~5 MB: Das Modell skaliert Eingaben auf etwa 1024 px herunter, größere Dateien verlängern nur die Upload-Zeit |
prompt | string | ✅ | Bearbeitungsanweisung |
quality | string | ✅ | low / medium / high |
n | number | — | Standard 1 |
size | string | — | auto bedeutet identisch mit dem Originalbild |
X-OfoxAI-Provider-Type | Header | — | Bindet die Anfrage an einen Anbieter. Dieser Endpunkt ist ein Multipart-Upload, daher wirkt nur der Header — ein Formularfeld extra_body wird stillschweigend ignoriert |
Antwort
Identisch zum Generieren:
{
  "created": 1777385669,
  "data": [
    { "b64_json": "<Bearbeitetes Bild Base64>", "index": 0 }
  ],
  "model": "openai/gpt-image-2",
  "size": "auto",
  "quality": "low",
  "usage": {
    "input_tokens": 1041,
    "input_tokens_details": { "image_tokens": 1024, "text_tokens": 17 },
    "num_input_images": 1,
    "output_tokens": 358,
    "total_tokens": 1399
  }
}
usage.input_tokens_details.image_tokens sind die vom Eingabebild verbrauchten Tokens, num_input_images ist die Anzahl der Eingabebilder.
Unterstützte Modelle und Preise findest du im Modellkatalog .
Aufruf
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.run/v1")

with open("apple.png", "rb") as f:
    resp = client.images.edit(
        model="openai/gpt-image-2",
        image=f,
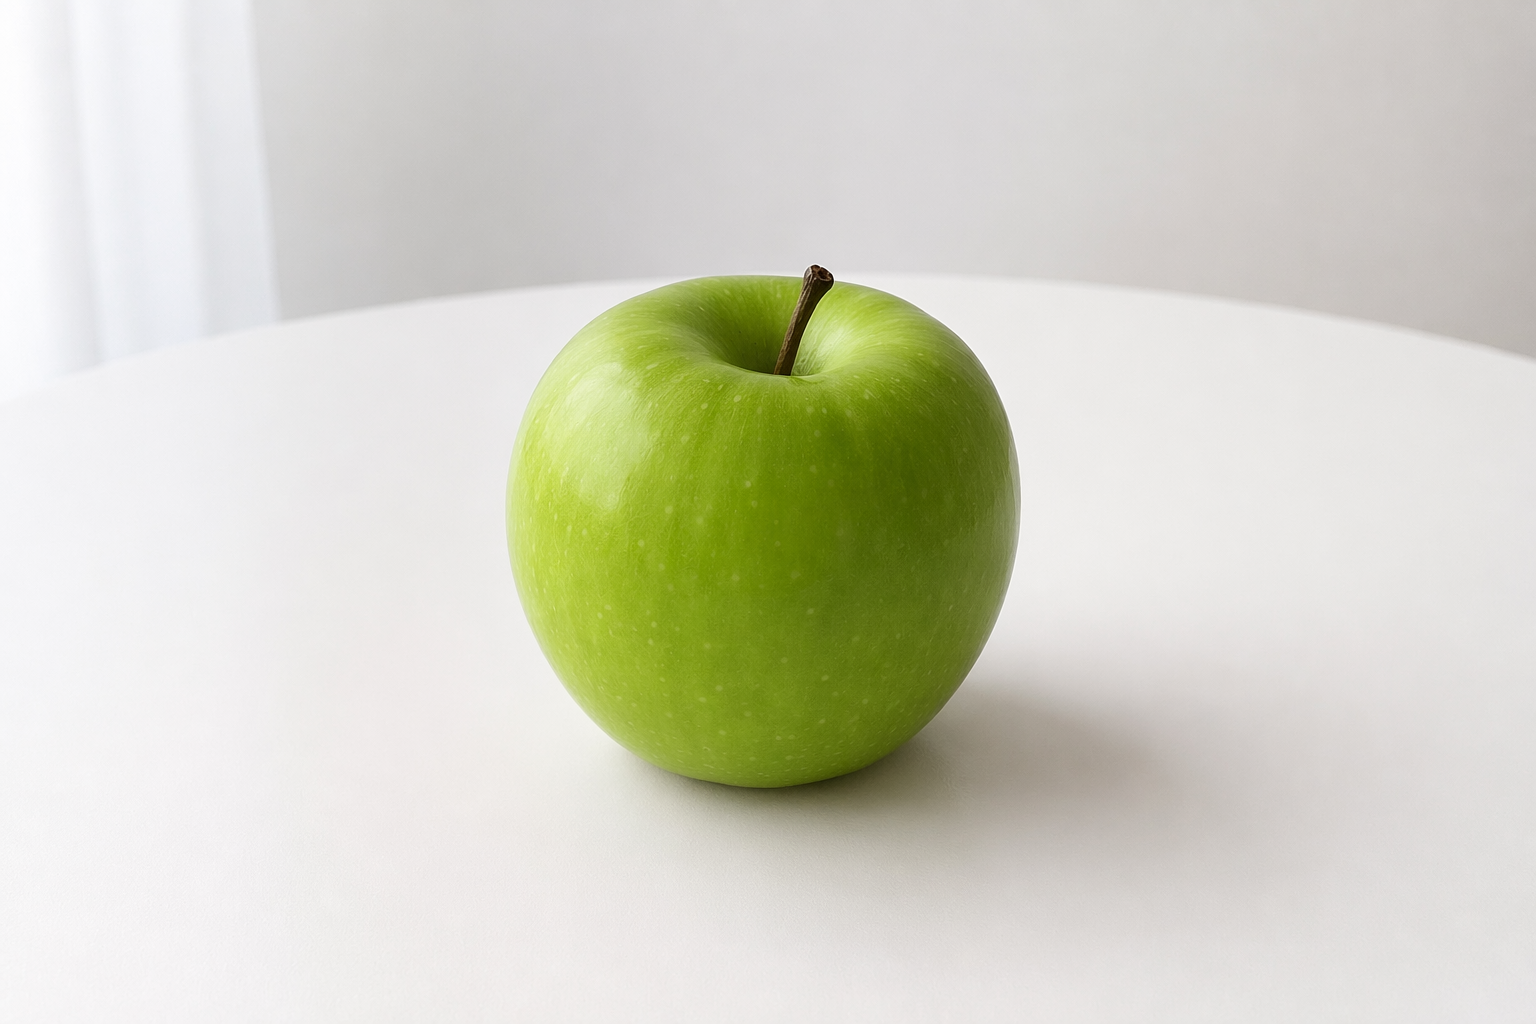
        prompt="Mach den Apfel grün, lass alles andere unverändert",
        size="auto",
        quality="low",
        # Optional: einen Anbieter festlegen. Dieser Endpunkt ist multipart, daher wirkt nur der Header
        # extra_headers={"X-OfoxAI-Provider-Type": "openai"},
    )

with open("apple_edited.png", "wb") as out:
out.write(base64.b64decode(resp.data[0].b64_json))Im Feld image wird ein lokaler Dateipfad übergeben (in cURL mit @-Präfix), keine URL.
Direkter Vergleich:
| Original | Nach Bearbeitung |
|---|---|
|  |