Das Enterprise-KI-Gateway für über 100 Modelle
— von Grund auf transparent
Über 100 Modelle hinter einer API — GPT, Claude, Gemini sowie DeepSeek, Qwen, GLM und Kimi, von Text bis zur Bild- und Videogenerierung. Im Team steuerbar: Rollen, Budgets und Audit-Trail sind eingebaut.
Unsere Enterprise-Zusagen in vier Zahlen
* Das SLA deckt die Verfügbarkeit der Ofox-Plattform ab. Ausfälle vorgelagerter Modellanbieter sind ausgenommen.
KI-Infrastruktur auf Enterprise-Niveau ab der ersten Anfrage
Eine API, ein Dashboard, eine Rechnung — mit der Steuerung, Zuverlässigkeit und Datenverarbeitung, die ein Produktiv-Rollout verlangt. Die 0 % Plattformgebühr sind dabei nur der Ausgangspunkt.
0 % Plattformgebühr — offizielle Anbieterpreise
Abgerechnet wird zum offiziellen Tarif des Modellanbieters — der Preis auf der Modellkarte ist der Preis, den Sie zahlen. Mit wachsendem Volumen greifen automatisch Mengenrabatte von bis zu 7 %.
Ein API-Key für GPT, Claude, Gemini und über 100 Modelle
Zugriff auf Claude, GPT, Gemini, DeepSeek, Qwen und über 100 Modelle mit einem einzigen API-Key. Vollständig kompatibel mit dem OpenAI SDK.
99,9 % Verfügbarkeits-SLA mit Failover über mehrere Regionen *
Redundanz über mehrere Regionen mit automatischem Failover. Verfügbarkeitszusagen schriftlich fixiert.
Granulare Kostenkontrolle je Key und je Nutzer
Legen Sie Tages-, Wochen- oder Monatsbudgets je Key oder je Nutzer fest, mit automatischer Ratenbegrenzung. Echtzeit-Dashboards beseitigen Rechnungsüberraschungen.
Keine dauerhafte Speicherung von Inhalten
Prompts und Antworten werden nie für Training verwendet. Gespeichert werden nur kurzlebige Betriebsprotokolle sowie Anfrage-Metadaten und Token-Verbrauch für die Abrechnung.
Gestaffelter technischer Support
Höheres Volumen verkürzt die Reaktionszeiten. Accounts der obersten Stufe erhalten einen festen technischen Ansprechpartner und bevorzugte Ticketbearbeitung.
LLM-Observability (Langfuse, Datadog, Weave)
DemnächstOptionales Logging von Prompts und Antworten, gestreamt an Langfuse, Datadog und weitere Plattformen für Debugging und Analyse — dieselbe Zuordnung wie im Dashboard, exportiert in den Observability-Stack, den Sie bereits betreiben.
* Das SLA deckt ausschließlich die Verfügbarkeit der Ofox-Plattform ab; Ausfälle vorgelagerter Modellanbieter sind ausgenommen.
Sicherheit und Compliance: weiterleiten statt speichern
Die Aufgabe eines Gateways ist es, Ihre Anfragen zu transportieren, nicht sie zu behalten. Der Datenverkehr ist TLS-verschlüsselt, Inhalte werden weder dauerhaft gespeichert noch für Training genutzt — und wo eine Zertifizierung noch läuft, sagen wir das unten genau so.
Wie Ihre Daten behandelt werden
TLS-verschlüsselt bei der Übertragung
Der gesamte API-Verkehr wird zwischen Ihren und unseren Systemen Ende-zu-Ende verschlüsselt.
Keine dauerhafte Speicherung von Prompts oder Antworten
Prompts und Antworten werden nicht dauerhaft gespeichert — es bleiben nur kurzlebige Betriebsprotokolle sowie die für die Abrechnung nötigen Anfrage-Metadaten und Token-Zahlen.
Ihre Daten werden nie für Training verwendet
Ihre Inhalte werden nicht zum Training von Modellen verwendet — weder für unsere noch für fremde. Vorgelagerte Anbieter sind an ihre eigenen Enterprise-Bedingungen gebunden.
Zertifizierungen und Datenvereinbarungen
SOC 2 Type II
Audit läuft — erwartet im 3. Quartal 2026
ISO 27001
Erwartet im 3. Quartal 2026
GDPR
AVV mit Standardvertragsklauseln; Unterauftragsverarbeiter-Liste auf Anfrage
DPA
Auf Anfrage, vor Vertragsunterzeichnung
Wir behaupten keine Zertifizierungen, die wir noch nicht besitzen. Wenn ein Standard für Ihren Prüfzeitplan entscheidend ist, sagen Sie uns Bescheid — wir teilen den aktuellen Stand des Audits mit.
Nutzungsanalytik für Entwicklungsteams
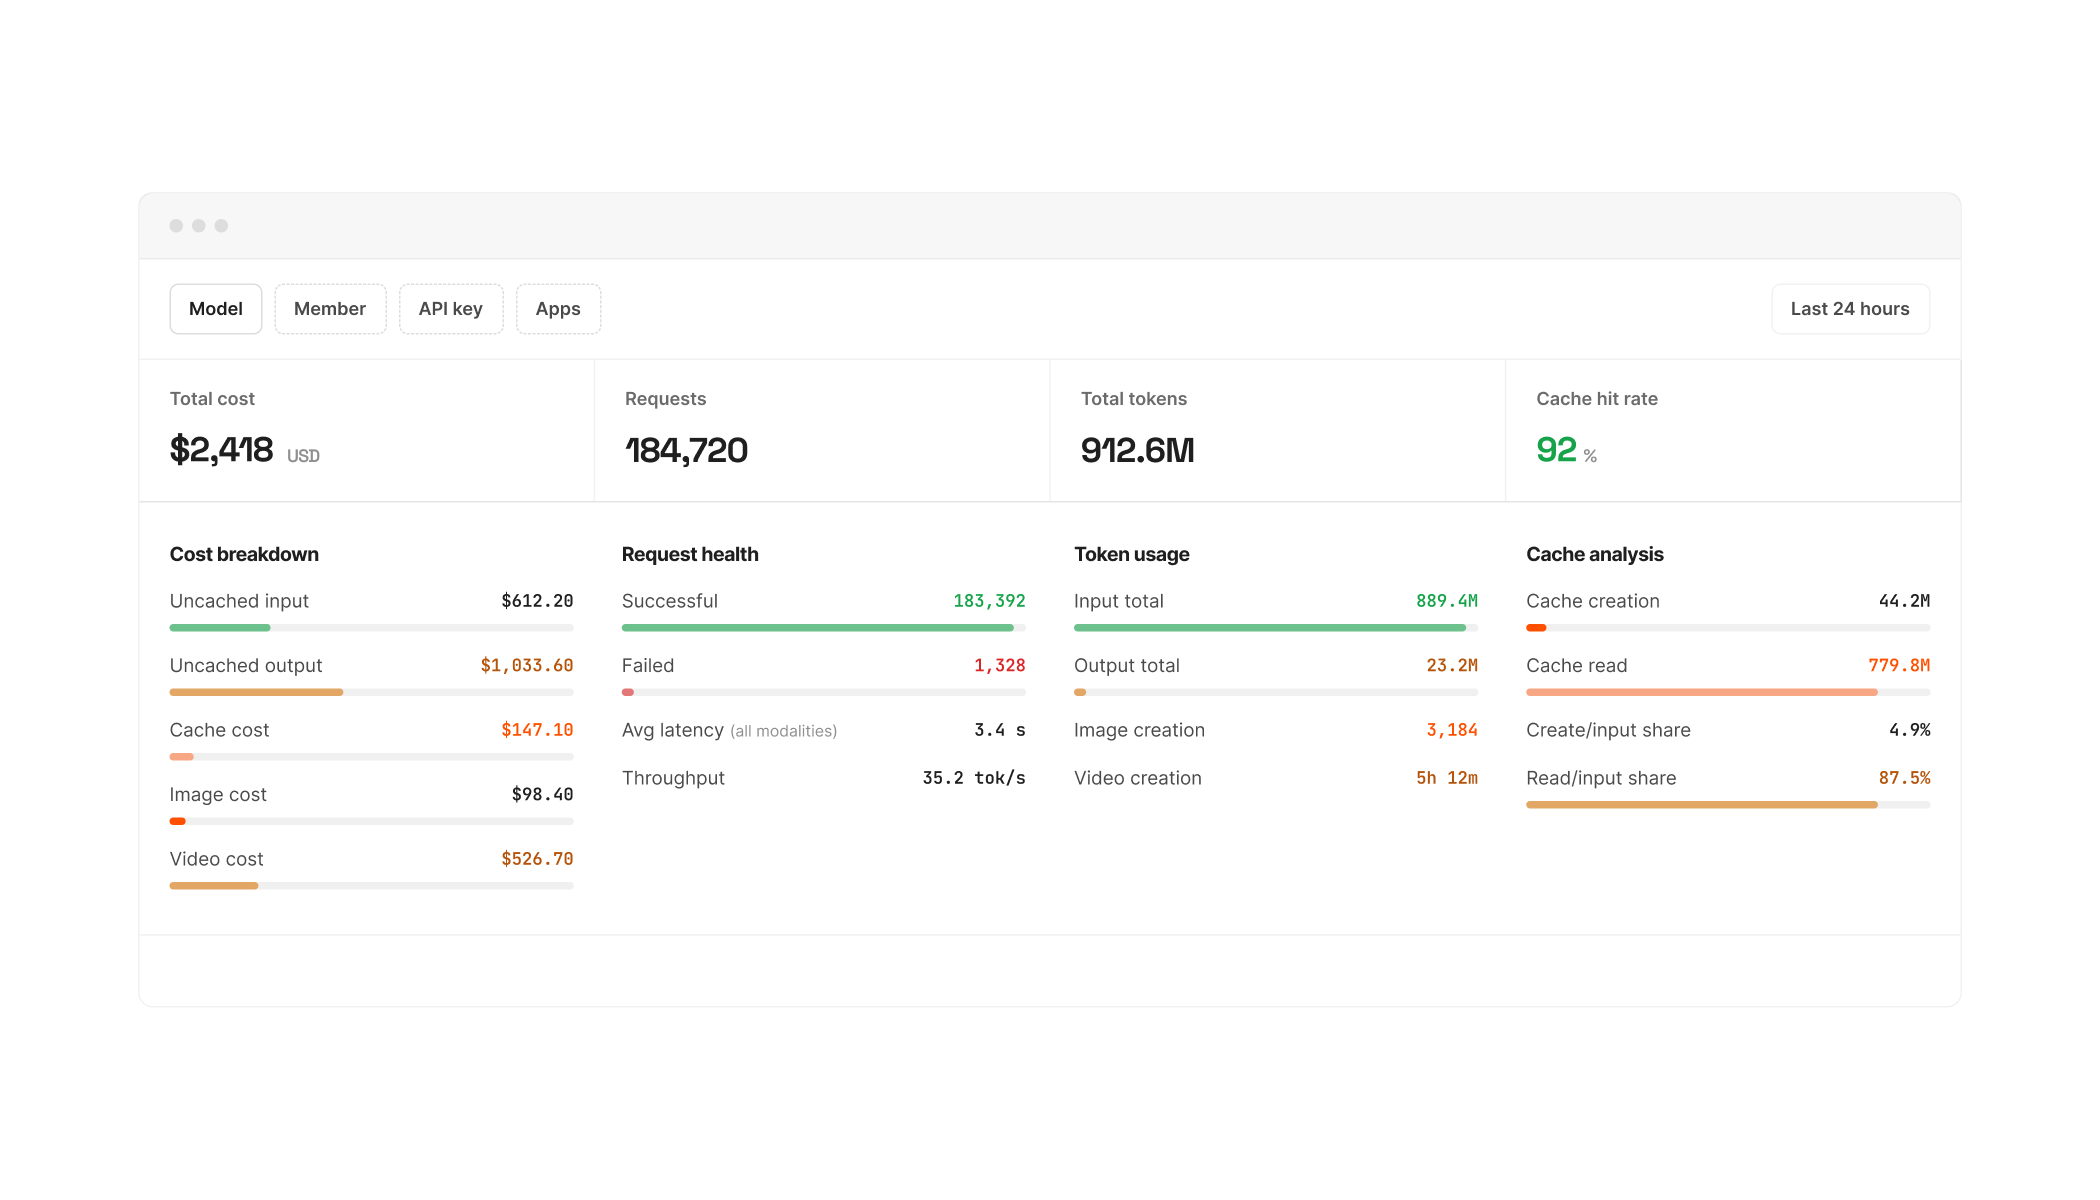
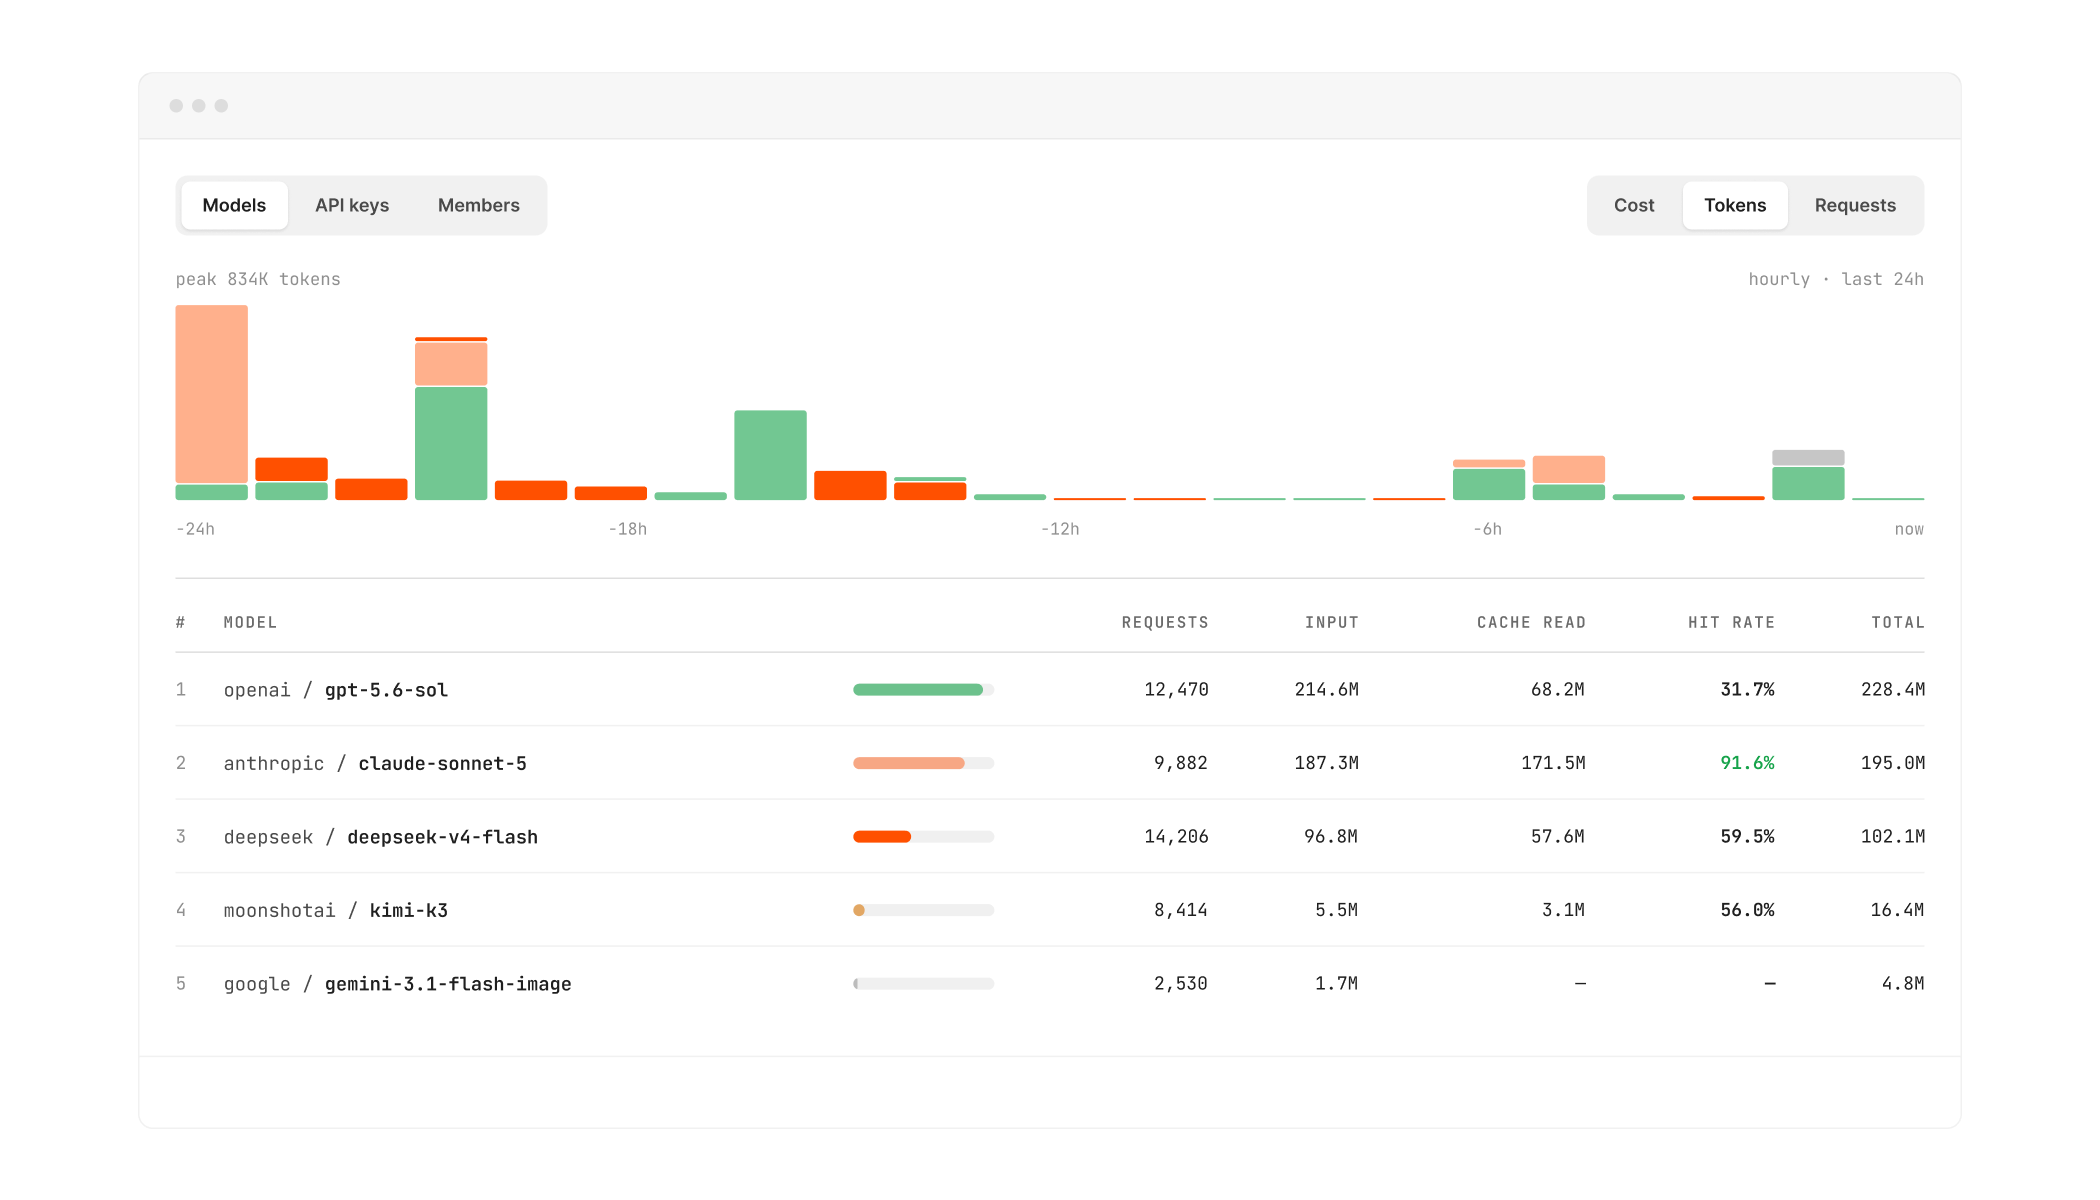
Kosten, Performance und Verbrauch in Echtzeit — zugeordnet zu jedem Modell, API-Key und Teammitglied. Ausgabenprüfung und Kapazitätsplanung laufen über Daten statt über den Monatsabschluss.
Integration: Base-URL ändern, SDK behalten
Ofox ist kompatibel mit den SDKs von OpenAI, Anthropic und Gemini. Kein Umschreiben, kein proprietärer Client.
Kompatibel mit den SDKs von OpenAI, Anthropic und Gemini
from openai import OpenAI

client = OpenAI(
    base_url="https://api.ofox.run/v1",  # ← die einzige Änderung
    api_key="YOUR_OFOX_API_KEY",
)

response = client.chat.completions.create(
    model="openai/gpt-5.6-sol",
    messages=[{"role": "user", "content": "Hello!"}],
)

print(response.choices[0].message.content)
Funktioniert mit Claude Code, Cursor, LangChain und mehr
Alle Integrationen


Wie ein Enterprise-Rollout abläuft
Schritt 1 Registrieren und testen
Account anlegen, Guthaben aufladen und die eigene Evaluierung fahren — für die Frage, ob Modelle, Latenz und Preise zu Ihrer Last passen, braucht es kein Vertriebsgespräch.
Schritt 2 Pilot mit gesetzten Budgets fahren
Bringen Sie eine einzelne Last mit gesetzten Budgets und Limits produktiv. Prüfen Sie Latenz, Qualität und Abrechnung an Ihren eigenen Zahlen.
Schritt 3 Mit Rollen und Key-Limits live gehen
Rollen und Budgets je Key im gesamten Team ausrollen. Höheres Volumen verkürzt die Reaktionszeiten und bringt einen festen technischen Ansprechpartner.
Enterprise-FAQ
Worin unterscheidet sich Ofox von den offiziellen APIs der Anbieter?
Sie behalten die offiziellen Preise — 0 % Plattformgebühr — und ersetzen viele Integrationen durch eine: ein Key, eine Rechnung und ein Dashboard für OpenAI, Anthropic, Google, DeepSeek, Qwen, GLM, Kimi und über 100 Modelle, mit eingebauten Rollen, Budgets und Audit-Trail. Direkt bedeutet je Anbieter eine eigene Geschäftsbeziehung, ein eigenes SDK und eine eigene Rechnung; Ofox bündelt das ohne Aufschlag.
Was deckt das SLA von 99,9 % ab?
Die Verfügbarkeit der Ofox-Plattform — Gateway, Routing und API-Schicht. Ausfälle, die bei einem vorgelagerten Modellanbieter entstehen, sind ausgenommen, da wir dessen Infrastruktur nicht kontrollieren. Die aktuellen Service-Credit-Bedingungen erhalten Sie auf Anfrage.
Was passiert, wenn ein vorgelagerter Modellanbieter ausfällt?
Störungen auf Plattformebene werden automatisch über unsere Regionen umgangen. Fällt der Anbieter selbst aus, geben wir den Fehler klar zurück, statt still die Qualität zu senken — und da die API modellunabhängig ist, wechseln die meisten Teams mit einer geänderten Zeichenkette auf ein gleichwertiges Modell. Solche Ausfälle sind vom SLA ausgenommen, und das sagen wir vorab.
Wie lange dauert die Integration?
Für die meisten Teams Minuten. Die API ist kompatibel mit den SDKs von OpenAI, Anthropic und Gemini: Sie ändern Base-URL und Key und behalten Ihren bestehenden Code.
Speichern Sie unsere Prompts und Antworten?
Nein. Anfrageinhalte werden in Echtzeit verarbeitet und nicht dauerhaft gespeichert — es bleiben nur kurzlebige Betriebsprotokolle sowie die für die Abrechnung nötigen Metadaten und Token-Zahlen. Der gesamte Verkehr ist bei der Übertragung TLS-verschlüsselt.
Werden unsere Daten für Modelltraining genutzt?
Nie. Ihre Prompts und Ausgaben werden nicht zum Training von Modellen verwendet — weder für unsere noch für fremde. Vorgelagerte Anbieter sind an ihre eigenen Enterprise-Bedingungen gebunden.
Sind Sie SOC-2-zertifiziert?
Noch nicht. Das SOC-2-Type-II-Audit läuft und wird für das 3. Quartal 2026 erwartet; ISO 27001 folgt demselben Zeitplan. Wir behaupten keine Zertifizierung, bevor sie erteilt ist — hängt Ihre Prüfung daran, melden Sie sich: Wir teilen den aktuellen Auditstand schriftlich mit.
Sind Sie DSGVO-konform?
Ja. Wir bieten einen AVV mit Standardvertragsklauseln, verschlüsseln den gesamten Verkehr bei der Übertragung, speichern Anfrageinhalte nicht dauerhaft und stellen auf Anfrage unsere Liste der Unterauftragsverarbeiter bereit. Melden Sie sich — wir stellen die Unterlagen für Ihre Prüfung zusammen.
Wie funktioniert die Preisgestaltung?
Nutzungsbasierte Abrechnung zum offiziellen Tarif des Modellanbieters, bei 0 % Plattformgebühr — der auf der Modellkarte ausgewiesene Preis ist der berechnete Preis. Keine Monatsgebühr, kein Plattform-Mindestumsatz, kein Aufschlag beim Aufladen. Dauerhaftes Volumen erzeugt automatisch Guthaben von bis zu 7 %.
Werden fehlgeschlagene Anfragen berechnet?
Nein. Fehlgeschlagene Anfragen liefern einen eindeutigen Fehler zurück und werden nicht berechnet — Sie zahlen ausschließlich für abgeschlossene Anfragen.
Verfällt vorausbezahltes Guthaben?
Nein. Ihr Guthaben bleibt verfügbar, bis Sie es aufbrauchen — ohne Ablaufdatum und ohne monatlichen Mindestumsatz, um es aktiv zu halten.
Wie begrenzen wir die Ausgaben eines Teammitglieds?
Setzen Sie in der Konsole ein Tages-, Wochen- oder Monatslimit je Mitglied oder je API-Key. Ist das Limit erreicht, werden Anfragen automatisch gedrosselt und der Zugriff startet in der nächsten Periode neu — kein Rechnungsschock durch ein außer Kontrolle geratenes Skript.
Können wir einschränken, welche Modelle unser Team aufrufen darf?
Ja. Zugriffe werden je Rolle und je Key gesteuert, sodass Sie die Nutzung auf einen freigegebenen Modellsatz begrenzen und zugleich Ausgabenlimits durchsetzen können.
Unterstützen Sie SSO?
Nennen Sie uns Ihren Identity-Provider, und wir bestätigen, was heute unterstützt wird und was auf der Roadmap steht.

Jedes Modell, das Ihr Team braucht — mit der Kontrolle, die Ihr Unternehmen erwartet.
Testen Sie zuerst ein Modell im Playground oder sprechen Sie mit uns über den Rollout in Ihrem Team — inklusive Modellen, Regionen und Prüfanforderungen.